Modelos bayesianos e otimização do risco para orçamentos de marketing, apresentado na PyData Berlim 2025.
Autor
Carlos Trujillo
Data de Publicação
20 de agosto de 2025
📘 Introdução
Este artigo explora como o Bayesian Media Mix Modeling (MMM) representa a incerteza e como podemos otimizar decisões de orçamento sob risco. Construímos uma visão generativa da resposta ao media (arrastamento via adstock, retornos decrescentes via saturação, tendência e sazonalidade) e utilizamos distribuições preditivas a posteriori completas para comparar alocações não apenas pelos resultados esperados mas também pela dispersão e pelo risco de cauda.
Este material acompanha a minha apresentação na PyData Berlim 2025, onde discuto a otimização prática sensível ao risco para MMM: ir além de planos focados apenas na média para objetivos que incorporam explicitamente a incerteza—e como comunicar estas trocas às partes interessadas.
📦 Importar bibliotecas
Código
import warningswarnings.filterwarnings("ignore", category=UserWarning)from pymc_marketing.mmm.builders.yaml import build_mmm_from_yamlfrom pymc_marketing.mmm import GeometricAdstock, MichaelisMentenSaturationfrom pymc_marketing.mmm.budget_optimizer import optimizer_xarray_builderfrom pymc_marketing.mmm.multidimensional import ( MultiDimensionalBudgetOptimizerWrapper,)from pymc_extras.prior import Priorfrom pymc_marketing.mmm import utility as utfrom scipy import ndimageimport arviz as azimport matplotlib.pyplot as pltimport seaborn as snsimport numpy as npimport pandas as pdimport xarray as xr
⚙️ Configuração do notebook
Código
az.style.use("arviz-darkgrid")plt.rcParams["figure.figsize"] = [8, 4]plt.rcParams["figure.dpi"] =100plt.rcParams["axes.labelsize"] =6plt.rcParams["xtick.labelsize"] =6plt.rcParams["ytick.labelsize"] =6plt.rcParams.update({"figure.constrained_layout.use": True})%load_ext autoreload%autoreload 2seed: int=sum(map(ord, "pydata_berlin_2025"))rng: np.random.Generator = np.random.default_rng(seed=seed)default_figsize = (8, 4) # repeat to use later
y_t é o resultado observado (ex., instalações de aplicações ou receita) no momento t
\beta_0 é o intercepto de base
f(x_{c,t}; \theta_c) é a função de resposta ao media para o canal c com investimento x_{c,t} e parâmetros \theta_c.
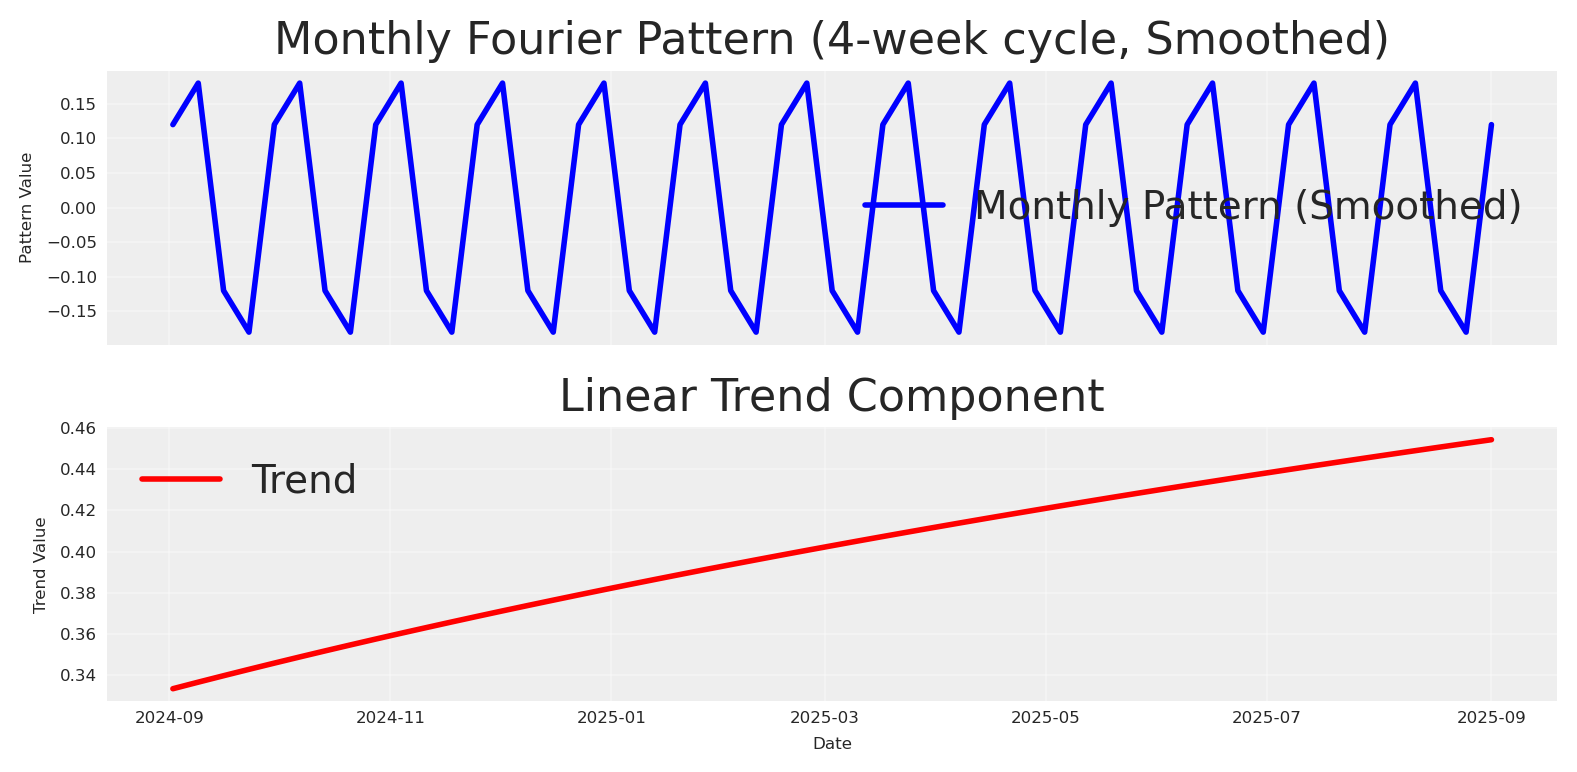
\text{trend}_t captura padrões de crescimento ou declínio a longo prazo
\text{seasonality}_t modela efeitos periódicos (padrões semanais, mensais)
\varepsilon_t representa a incerteza aleatória—ruído irreductível de fatores não observados, erro de medição e aleatoriedade inerente que permanece mesmo com conhecimento perfeito de todos os parâmetros
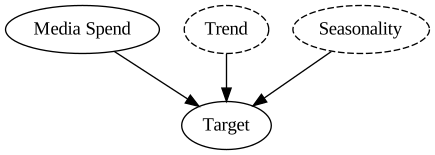
Não consideramos interações; o DAG causal apresenta-se assim:
A configuração YAML codifica um MMM totalmente bayesiano com priors sobre os mecanismos de resposta centrais e a estrutura temporal. Para especificidades do modelo e exemplos trabalhados, consulte a Galeria de Exemplos e a API do PyMC‑Marketing.
Aqui dividimos os dados em conjuntos de treino e teste. Não para avaliar o ajuste; em vez disso, utilizamos o conjunto de teste para comparar os resultados da otimização, verificando se será “melhor” do que as recomendações de orçamento do plano atual/corrente.
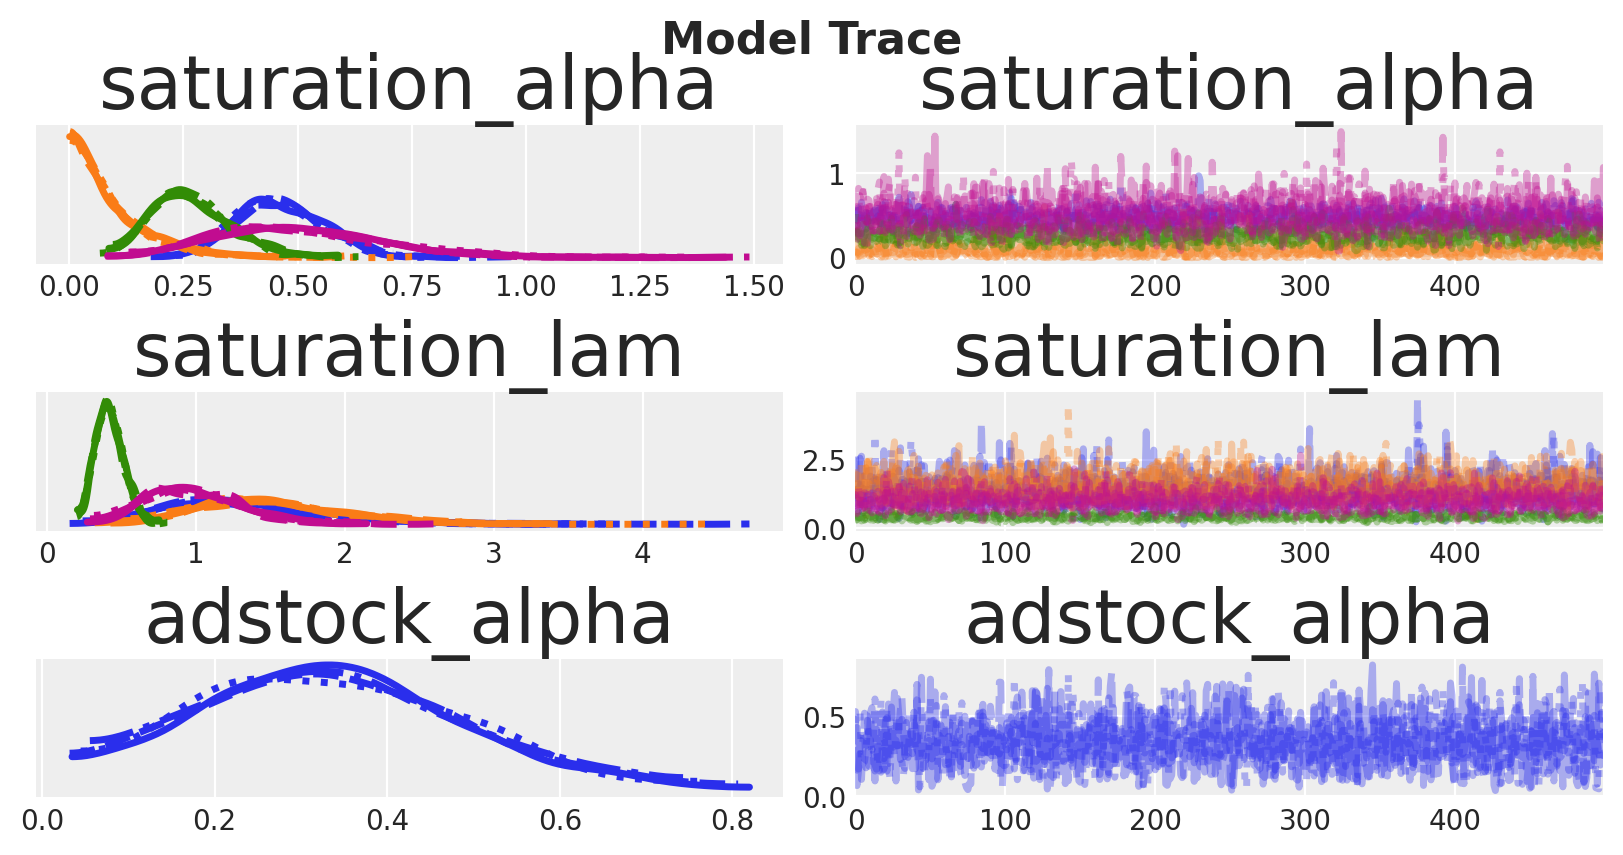
Como esperado, alguns parâmetros estão bem identificados enquanto outros permanecem incertos.
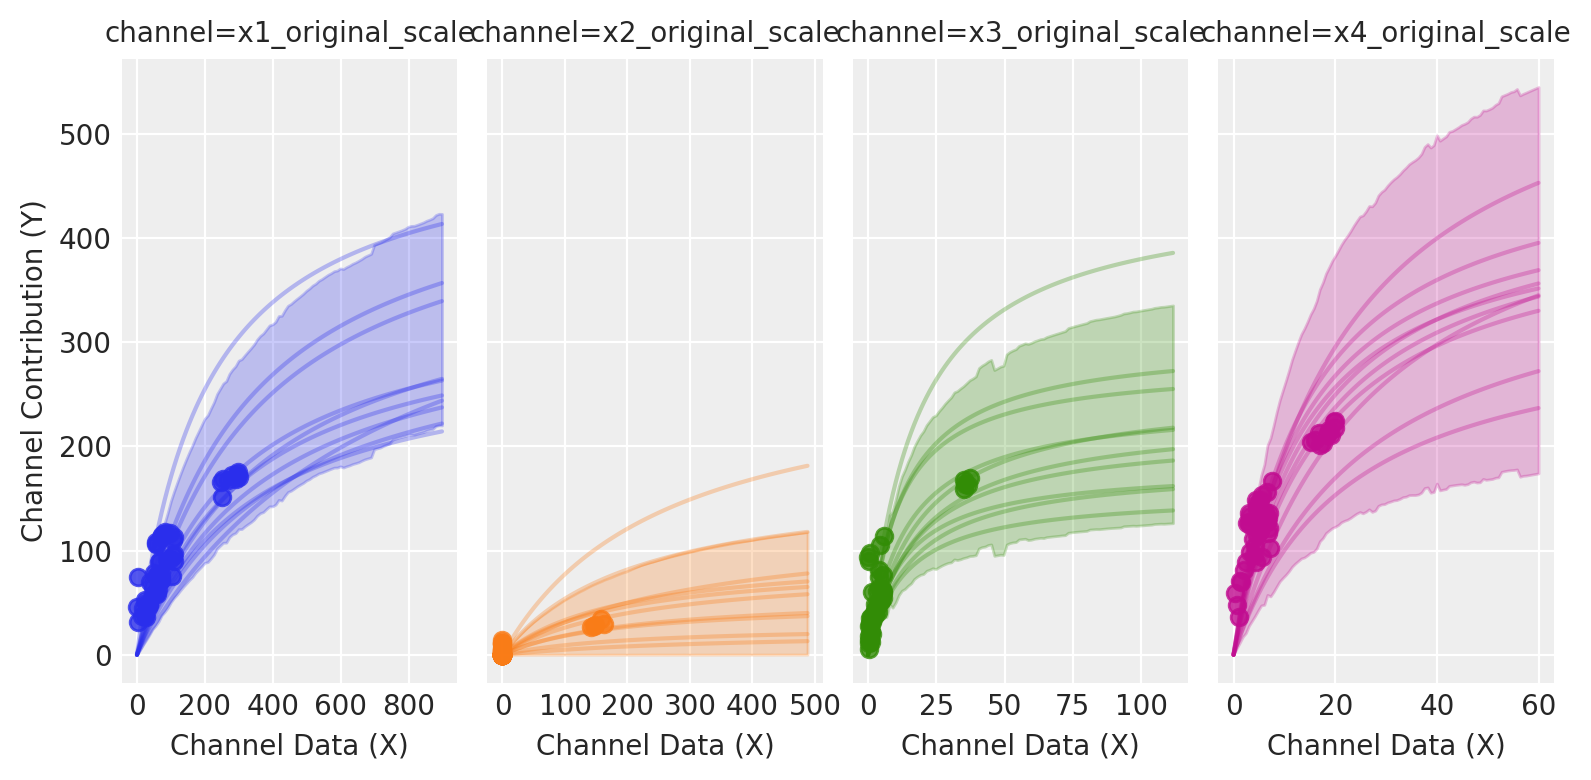
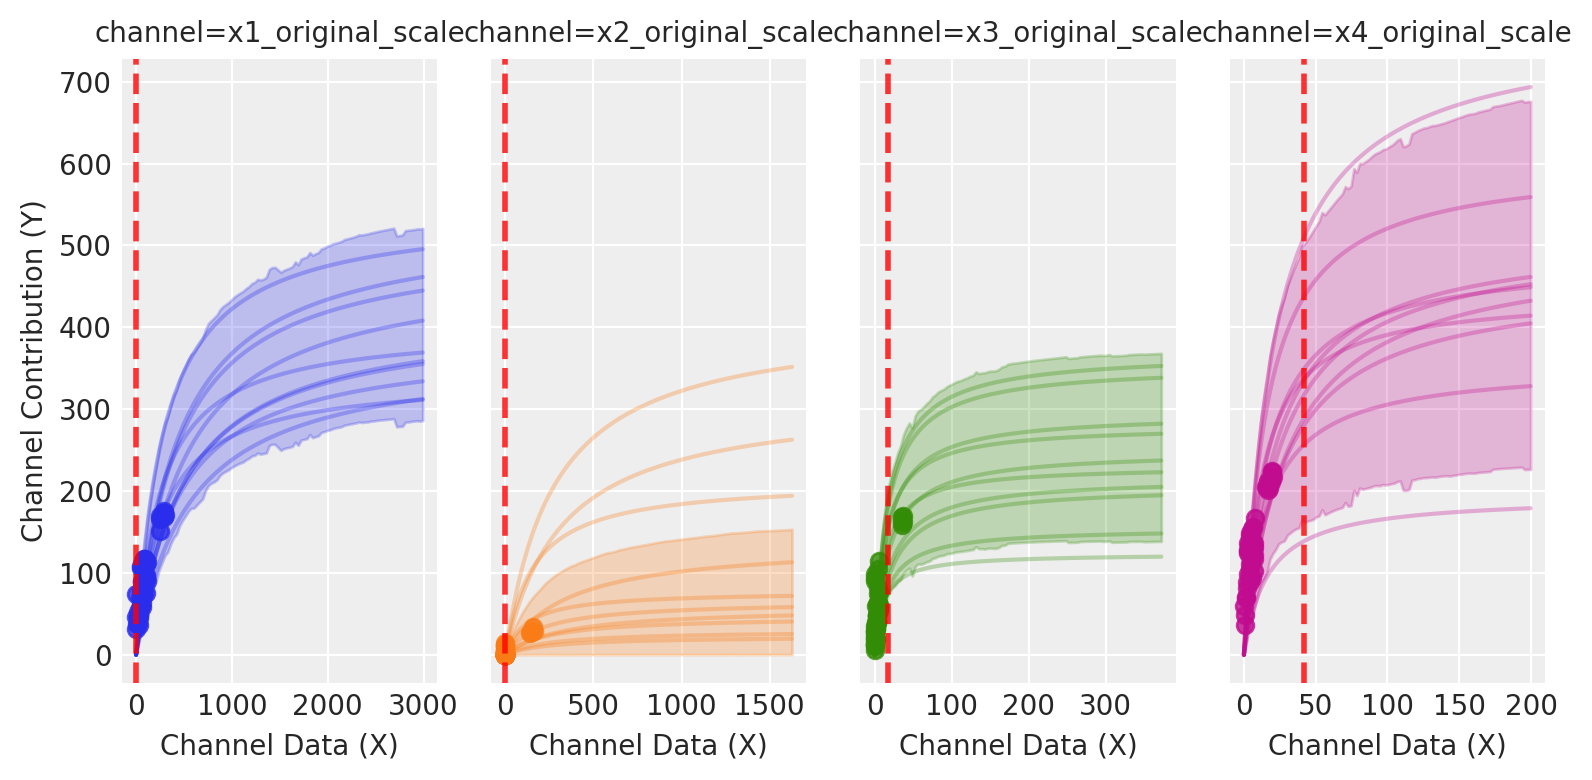
Amostrar curvas de saturação a partir do posterior ajuda-nos a visualizar a incerteza dos parâmetros como bandas em torno da resposta de cada canal. Bandas largas indicam retornos marginais mal identificados; alocar nessas regiões aumenta a variância do resultado porque pequenas mudanças nos parâmetros causam grandes alterações na resposta.
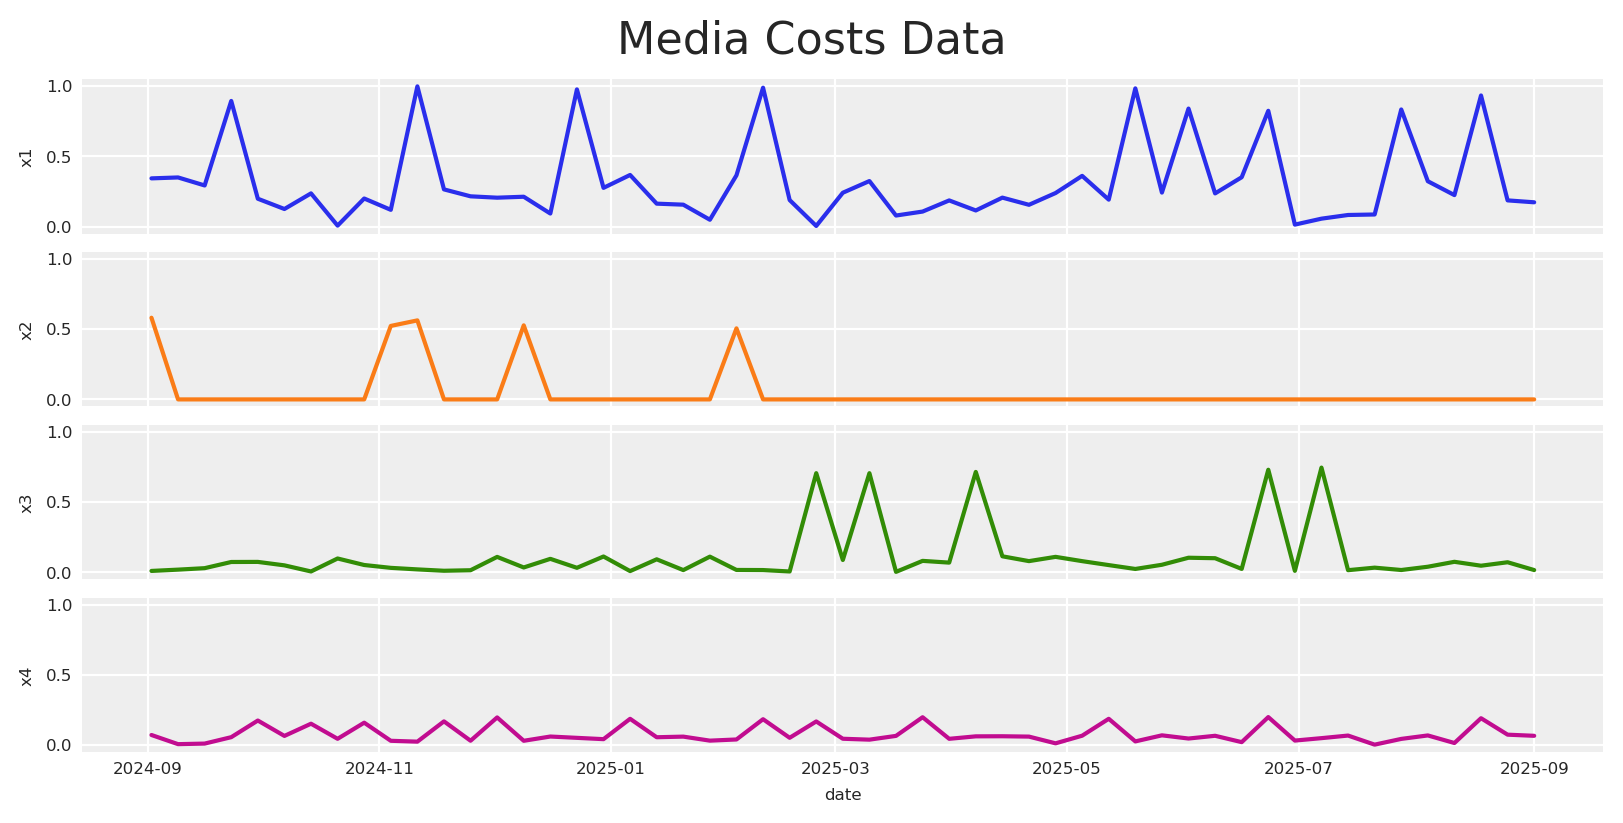
A imagem é clara: canais como X1 e X3 exibem mais variação ao longo dos níveis de investimento, permitindo que o modelo aprenda os seus parâmetros com mais precisão. Canais como X2 e X4 têm gastos relativamente constantes com menos variação, por isso os seus parâmetros são estimados com maior incerteza.
🎲 Compreender a incerteza
Num MMM bayesiano modelamos explicitamente duas formas de incerteza que se acumulam nas previsões e nas decisões de orçamento:
Incerteza aleatória: aleatoriedade nos resultados condicional em parâmetros fixos. Na simulação, é epsilon. Formalmente, se os parâmetros são \theta, a incerteza aleatória é a dispersão de p(y\mid x,\theta) quando modelamos a verosimilhança como \mathcal{N}(0, \sigma^2). No nosso modelo, o parâmetro \sigma captura explicitamente a incerteza aleatória: quantifica a quantidade de variabilidade do resultado que permanece mesmo que todos os parâmetros estruturais \theta fossem conhecidos exatamente. Representa a imprevisibilidade inerente devido a micro-variações não observadas, choques de procura ou ruído de registo. Mesmo com dados infinitos, a incerteza aleatória permanece.
Incerteza epistémica: incerteza sobre os parâmetros e as próprias funções latentes devido a dados limitados ou pouco informativos. É a dispersão do posterior p(\theta\mid \text{data}). Diminui com mais dados, melhores priors ou variação experimental mais rica. No nosso modelo inclui memória de arrastamento (adstock \alpha), curvatura de saturação e semi-saturação (Michaelis–Menten \alpha,\lambda), declives de tendência e pesos sazonais de Fourier.
Porquê esta separação é importante para o planeamento:
Distribuição do resultado sob um plano. Para um dado plano de alocação b ao longo dos canais e do tempo, a preditiva a posteriori é
p\big(Y(b)\mid \text{data}\big) = \int p\big(Y(b)\mid \theta\big)\, p(\theta\mid \text{data})\, d\theta,
que mistura a variabilidade aleatória (o termo interno) e a variabilidade epistémica (integração sobre \theta). O nosso estimador de Monte Carlo amostra \theta^{(s)} do posterior, simula o arrastamento e a saturação sob b, e extrai resultados preditivos.
Exemplo: curvatura conhecida vs desconhecida. Suponha que a saturação de um canal é bem aprendida em torno dos gastos históricos mas não além disso. Dois planos com o mesmo gasto total diferem no risco:
O Plano A concentra-se em torno da moda histórica (epistemicamente baixo), produzindo uma distribuição preditiva estreita.
O Plano B ultrapassa os gastos observados (epistemicamente alto), produzindo uma distribuição mais larga e caudas de desvantagem mais pesadas se a curva se aplanar mais cedo do que o esperado.
Durante a otimização, focamo-nos no segundo componente —incerteza epistémica— e podemos escolher quanta confiança exigimos em torno dela. Uma vez escolhida uma alocação, incorporamos então a incerteza aleatória para quantificar a distribuição total de resposta, se assim o desejarmos.
🧭 Otimização
Pensemos no nosso modelo e nos seus resultados, começando pela distribuição preditiva a posteriori:
p\big(Y(b)\mid \text{data}\big) = \int p\big(Y(b)\mid \theta\big)\, p(\theta\mid \text{data})\, d\theta
Como pode ver, a distribuição preditiva a posteriori incorpora tanto a incerteza aleatória como a epistémica, o que significa que o problema de otimização se reduz a escolher uma alocação b que otimize um sumário escalar desta distribuição.
Formalmente, seja b \in \mathbb{R}^C uma alocação exequível (ex., orçamentos dos canais) com restrições
\sum_{c=1}^C b_c = B, \qquad \underline{b}_c \leq b_c \leq \overline{b}_c.
Para cada alocação candidata b, obtémos sorteios de Monte Carlo da distribuição preditiva a posteriori:
\{Y^{(s)}(b)\}_{s=1}^S \sim p(Y \mid \mathrm{do}(X=b), \mathcal{D}),
É então calculada uma estatística (por exemplo, a média, um quantil, uma pontuação ajustada ao risco ou a mean tightness score).
\phi\!\left(\{Y^{(s)}(b)\}\right)
Por consequência, o problema de otimização resolvido pelo SLSQP é simplesmente
\min_{b \in \mathcal{B}} J(b), \qquad J(b) = f\!\left(\phi(\{Y^{(s)}(b)\})\right),
onde f é definida para que o solucionador minimize a estatística escolhida a partir da distribuição preditiva a posteriori.
Esta formulação é flexível: ao mudar \phi, podemos almejar critérios neutros ao risco ou sensíveis ao risco, ou até heurísticas, ancorando sempre a decisão na distribuição preditiva a posteriori.
💡 Notas sobre pressupostos
Porquê dizemos do=(X=b)?
Invariância estrutural: As funções de resposta (tendência, sazonalidade, adstock, saturação, ligação) são invariantes sob intervenções b ao longo do horizonte de otimização.
Sem confundidores não medidos: Condicional nas covariáveis incluídas e controlos temporais, não existem confundidores não medidos (especialmente variáveis no tempo) que afetem tanto o investimento como o resultado; o critério de backdoor é satisfeito.
Utilizamos p\big(Y \mid \mathrm{do}(X=b), \mathcal{D}\big) como abreviatura para a preditiva a posteriori sob estes pressupostos. Quando as alocações se afastam muito do suporte, os resultados tornam-se extrapolativos e devem ser tratados como análise de sensibilidade em vez de efeitos identificados.
👀 Realmente bayesiano?
A nossa abordagem difere da “otimização bayesiana” no sentido de ML (que modela sequencialmente o objetivo com um substituto e otimiza uma função de aquisição). Em contraste, já temos o posterior completo p(\theta \mid \text{data}), que propagamos na preditiva a posteriori p(Y(b)\mid \text{data}). A otimização opera então sobre um funcional escalar \phi desta distribuição. Isto pode ser visto como uma compressão da preditiva a posteriori num sumário relevante para a decisão, mas não como uma perda de informação bayesiana. A otimização permanece totalmente bayesiana porque o critério depende inteiramente de sorteios a posteriori.
🛠️ Definir o otimizador
Inicializar o otimizador é simples: passe o modelo e o intervalo de datas.
Utilizaremos o conjunto de teste para definir o orçamento e o período de otimização para que possamos comparar a alocação resultante com o nosso plano atual.
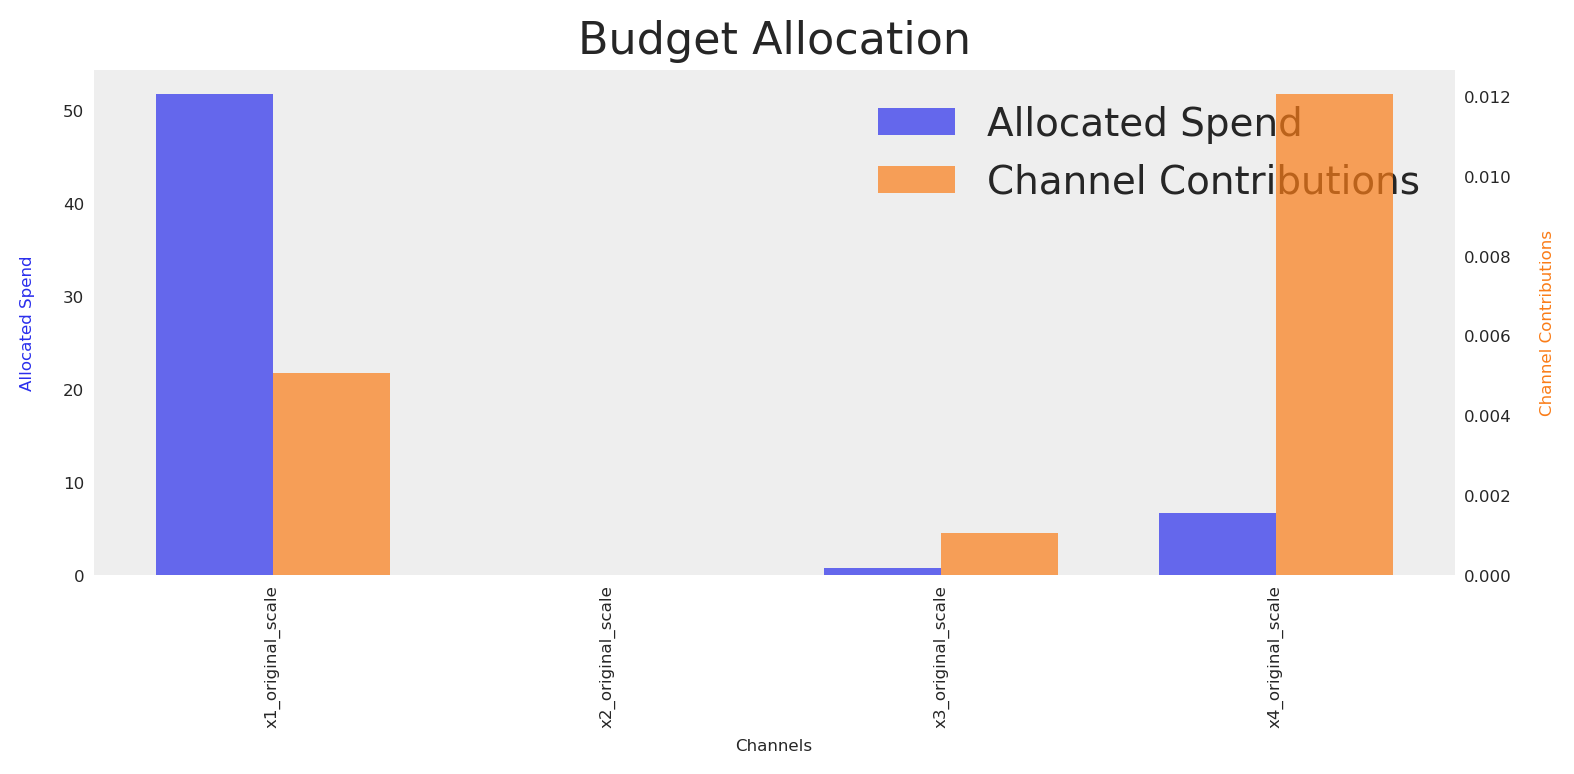
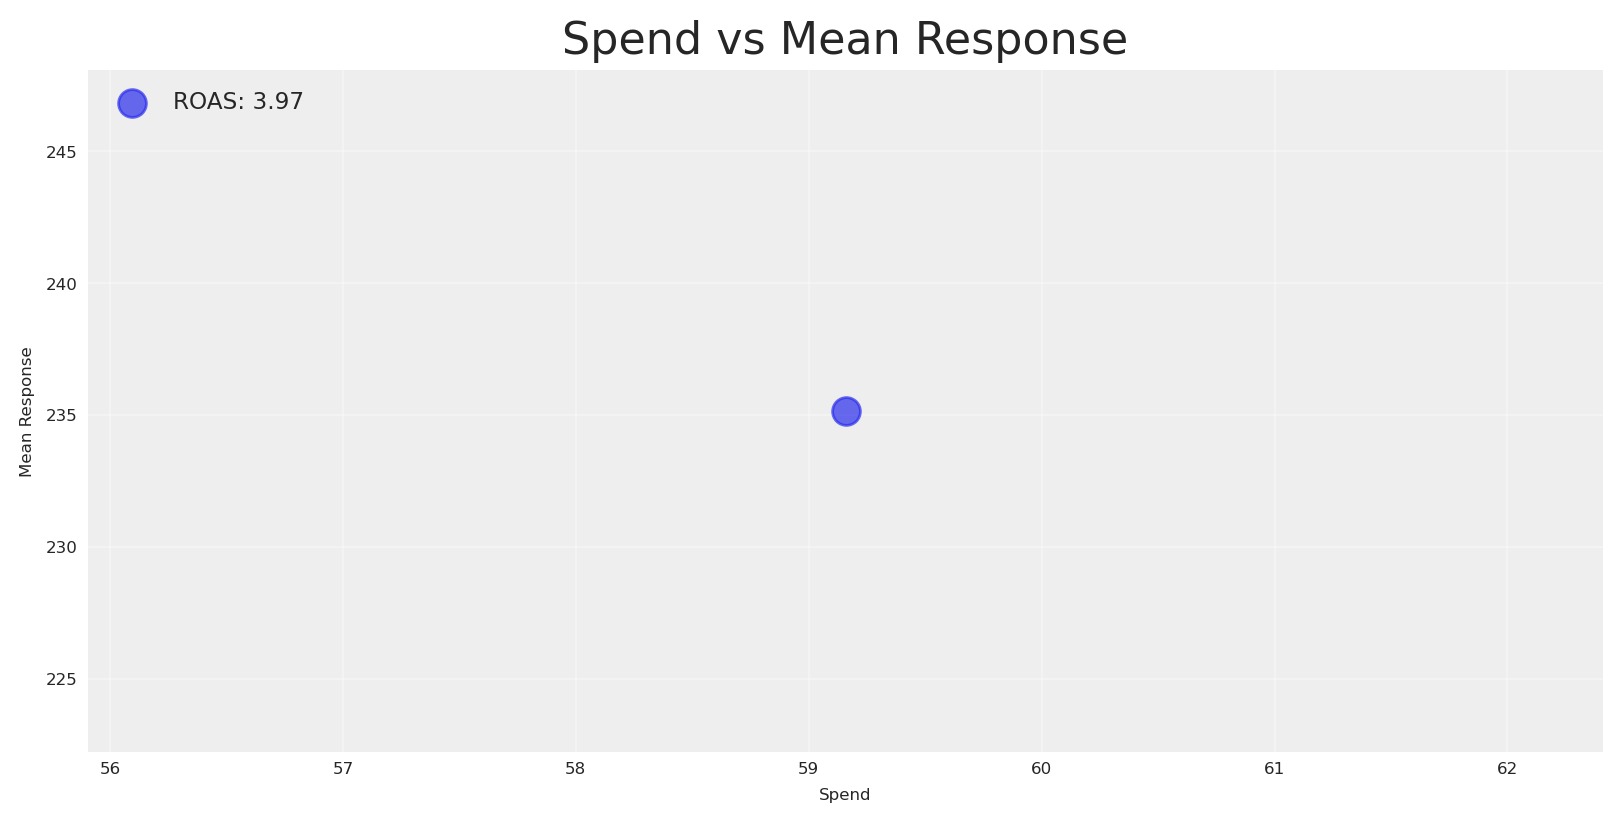
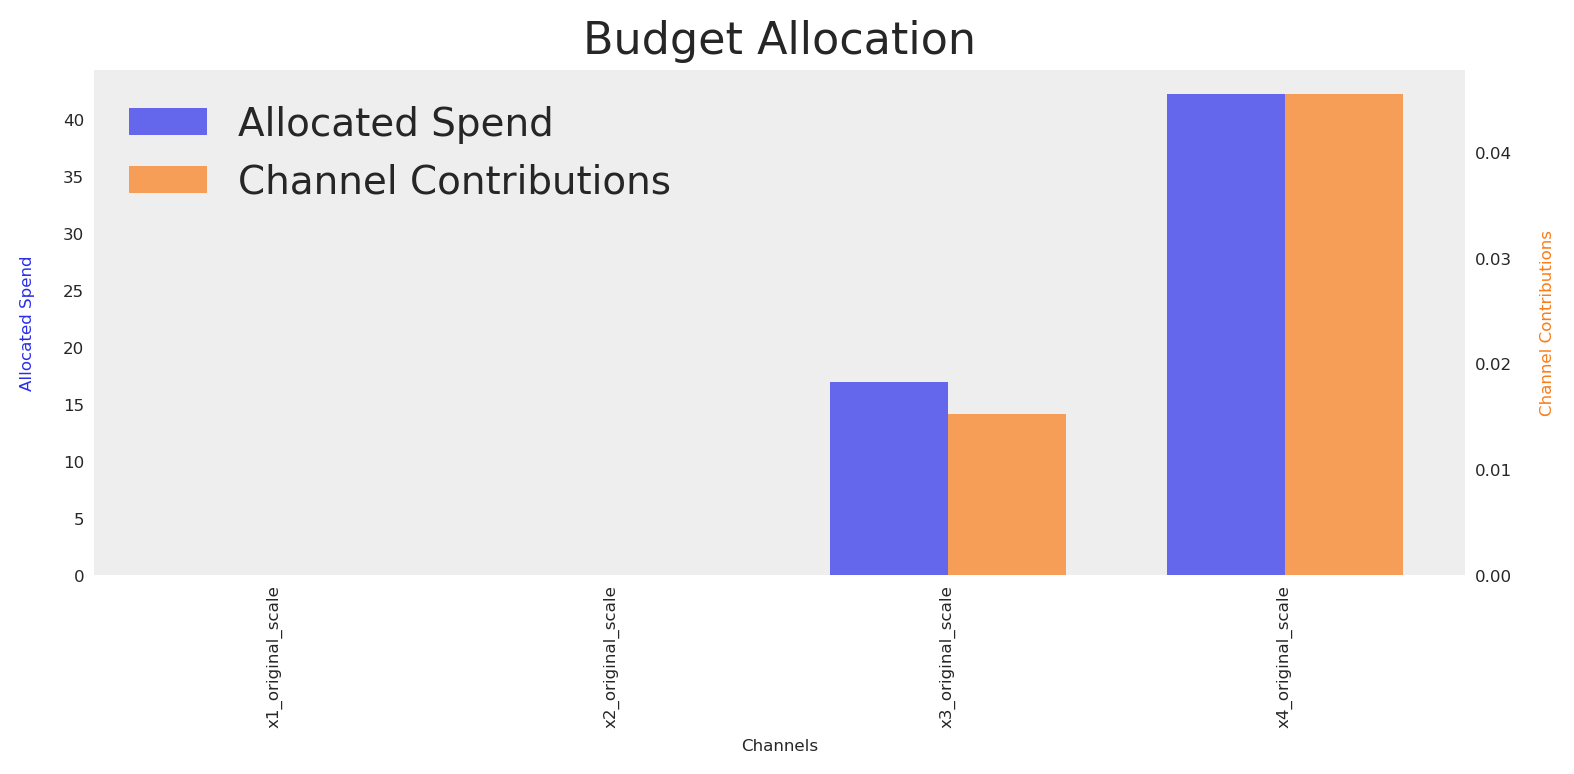
O plot.budget_allocation por defeito gera um gráfico de barras com a alocação e a resposta por canal. Para ver os totais, podemos somar e criar um simples gráfico de dispersão com uma etiqueta para o ROAS.
Código
# Create scatterplot with spend and mean responsespend = initial_posterior_response.allocation.sum().valuesmean_response = initial_posterior_response.total_media_contribution_original_scale.mean(dim='sample').valuesinitial_roas = mean_response / spendplt.scatter(spend, mean_response, alpha=0.7, s=100, label=f"ROAS: {initial_roas:.2f}")plt.xlabel('Spend')plt.ylabel('Mean Response')plt.title('Spend vs Mean Response')plt.grid(True, alpha=0.3)plt.legend(fontsize='small', loc='upper left')plt.show()
Obtivemos um ROAS de 3.9 para o plano inicial, que está abaixo do nosso ROAS alvo (digamos 8). Agora podemos executar uma otimização simples para responder à questão: podemos realocar para alcançar uma resposta mais alta dado o mesmo orçamento?
Budget allocation by channel:
  x1_original_scale: 0
  x2_original_scale: 0
  x3_original_scale: 16
  x4_original_scale: 42
Total Allocated Budget: 59
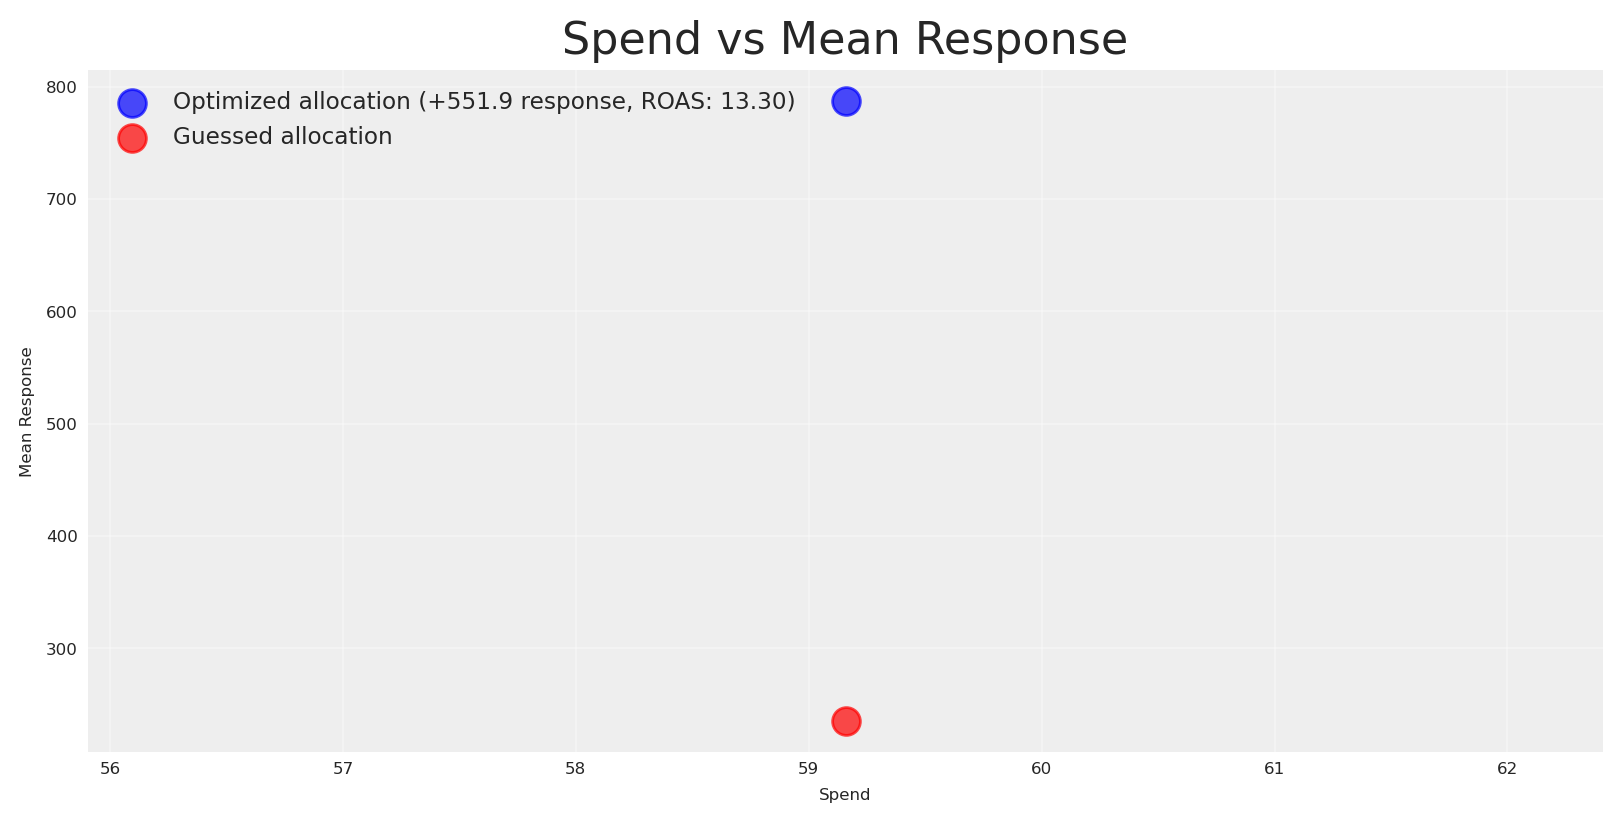
Sim, fazemos. Vamos comparar a resposta otimizada com o plano de base.
Código
# Create scatterplot with spend and mean responsemean_response_v2 = naive_posterior_response.total_media_contribution_original_scale.mean(dim='sample').valuesroas_v2 = mean_response_v2 / spend# Calculate the delta in responseresponse_delta = mean_response_v2.sum() - mean_response.sum()plt.scatter(spend, mean_response_v2, alpha=0.7, s=100, color="blue", label=f"Optimized allocation (+{response_delta:.1f} response, ROAS: {roas_v2:.2f})")plt.scatter(spend, mean_response, alpha=0.7, s=100, color="red", label="Guessed allocation")plt.xlabel('Spend')plt.ylabel('Mean Response')plt.title('Spend vs Mean Response')plt.grid(True, alpha=0.3)plt.legend(fontsize='small', loc='upper left')plt.show()
A alocação otimizada é ~500 unidades superior à alocação adivinhada, e o novo ROAS estimado é 13, que está acima das nossas expectativas. Por consequência, assumimos que obteremos uma receita Y estimada nos próximos N períodos e, planearando contra este fluxo de caixa entrante, recuperaremos.
A reviravolta? Obtivemos uma resposta mais baixa, o que significa um ROAS mais baixo e tivemos problemas financeiros sérios porque não temos dinheiro suficiente para pagar aos fornecedores ou serviços.
Porquê acontece isto? Maximizar a resposta média é neutro ao risco. Frequentemente realoca o orçamento para regiões com potencial de altos retornos mesmo que estejam mal identificadas, aumentando a dispersão dos resultados. Isto é racional quando as partes interessadas são indiferentes ao risco. No entanto, não é o caso de todas as empresas. Por vezes, as nossas partes interessadas precisam de saber quão certos estamos sobre os resultados esperados.
Ao inspecionar amostras preditivas a posteriori sob cada alocação, podemos quantificar a incerteza e responder a esta questão, com base na compreensão atual do modelo.
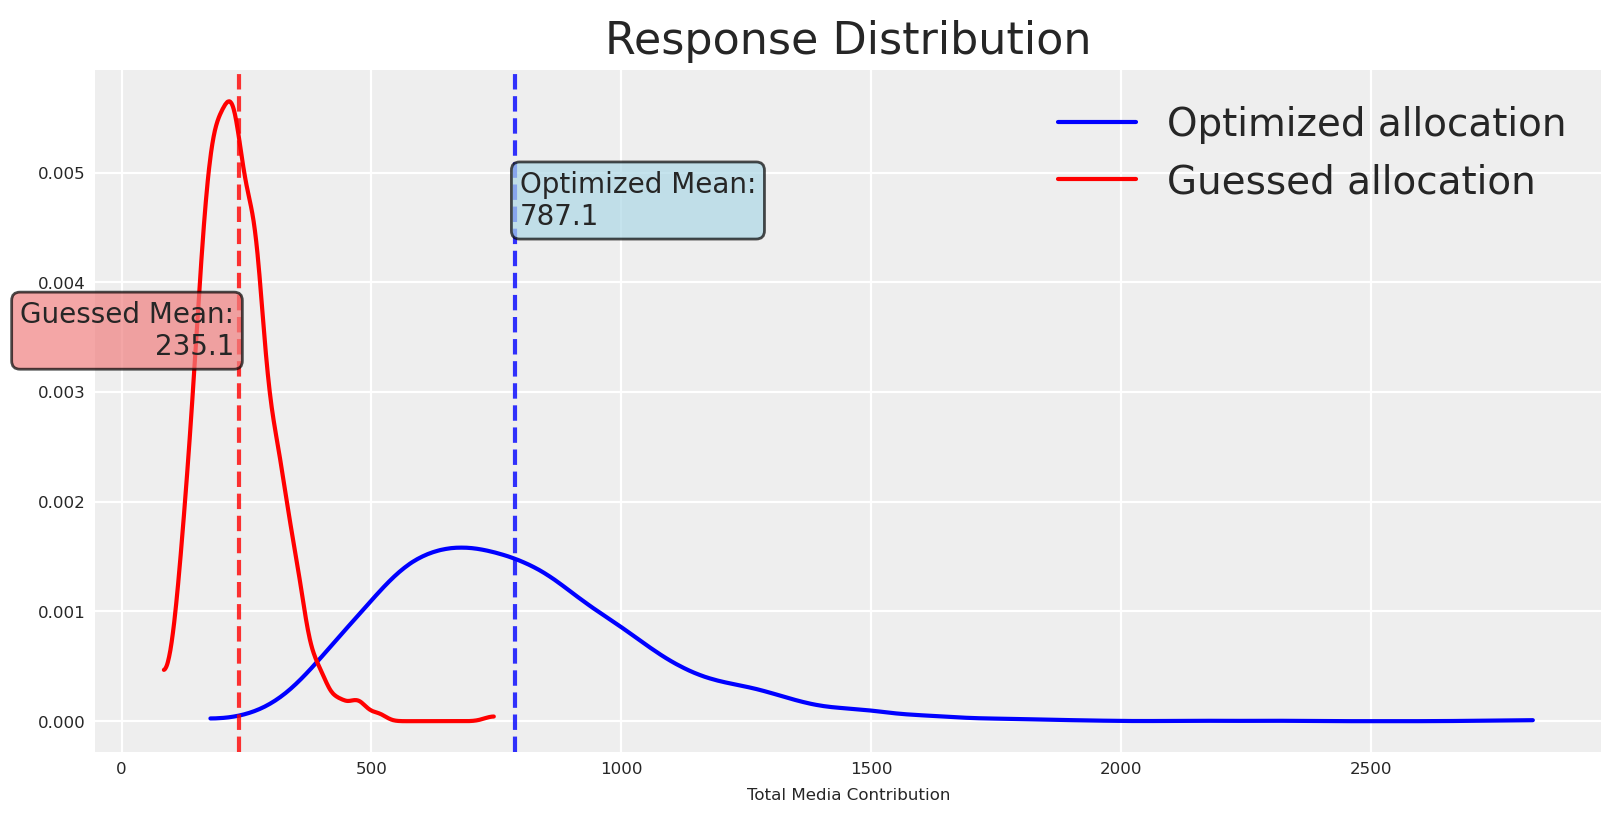
Vamos representar as distribuições de resposta tanto para a alocação de base como para a otimizada.
Código
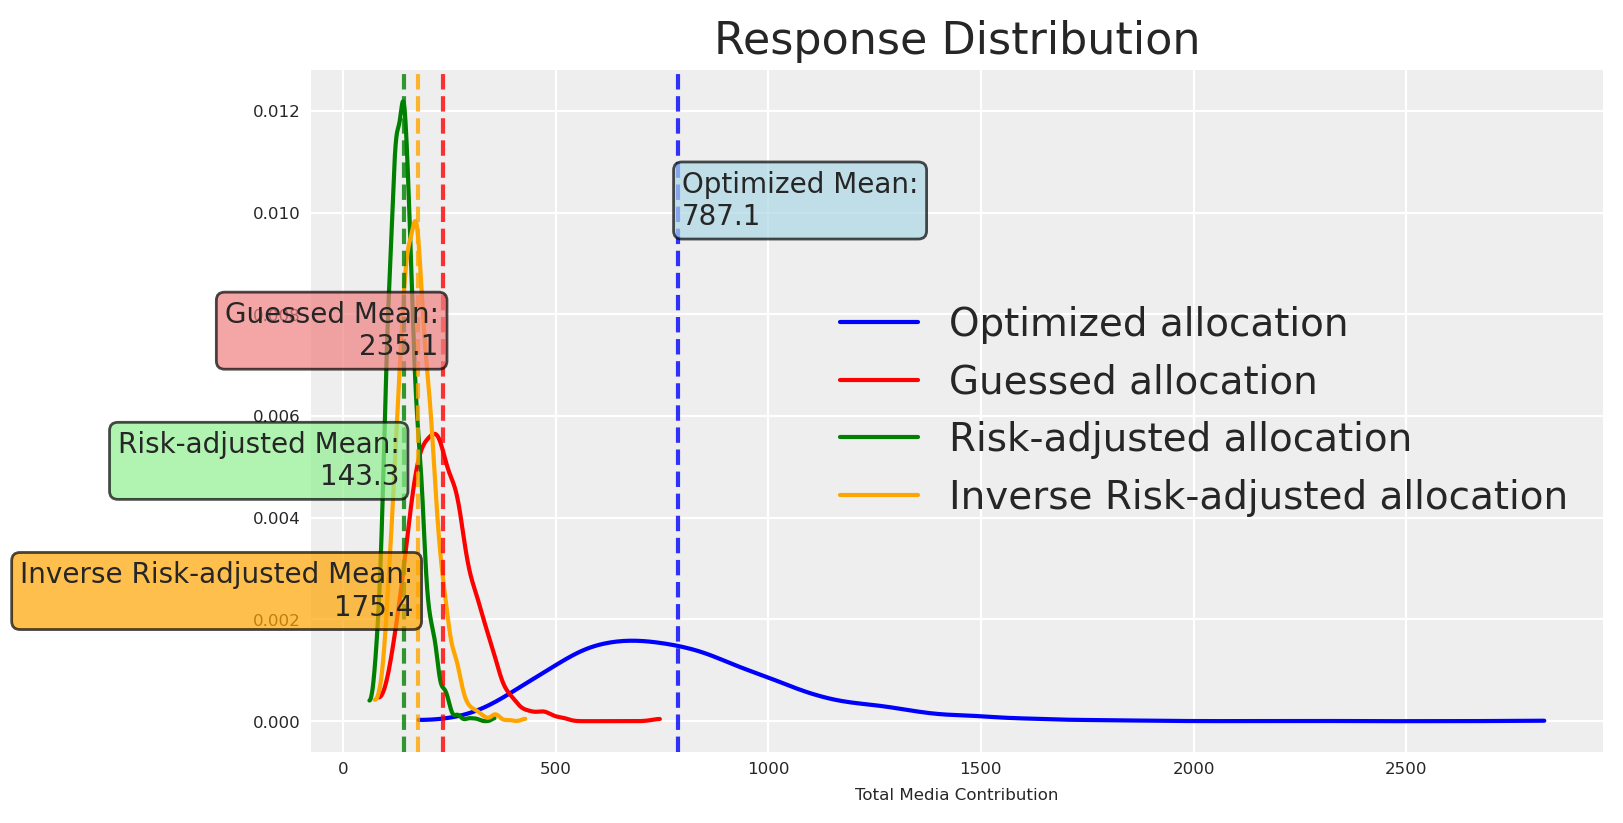
fig, ax = plt.subplots()# Get the valuesoptimized_values = naive_posterior_response.total_media_contribution_original_scale.valuesguessed_values = initial_posterior_response.total_media_contribution_original_scale.values# Plot distributionsaz.plot_dist( optimized_values, color="blue", label="Optimized allocation", ax=ax,)az.plot_dist( guessed_values, color="red", label="Guessed allocation", ax=ax,)# Calculate meansoptimized_mean = optimized_values.mean()guessed_mean = guessed_values.mean()# Add vertical lines for meansax.axvline(optimized_mean, color="blue", linestyle="--", alpha=0.8)ax.axvline(guessed_mean, color="red", linestyle="--", alpha=0.8)# Add text boxes with mean valuesax.text(optimized_mean +10, ax.get_ylim()[1] *0.8, f'Optimized Mean:\n{optimized_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightblue", alpha=0.7), ha='left', va='center')ax.text(guessed_mean -10, ax.get_ylim()[1] *0.6, f'Guessed Mean:\n{guessed_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightcoral", alpha=0.7), ha='right', va='center')plt.title("Response Distribution")plt.xlabel("Total Media Contribution")plt.legend()plt.show()
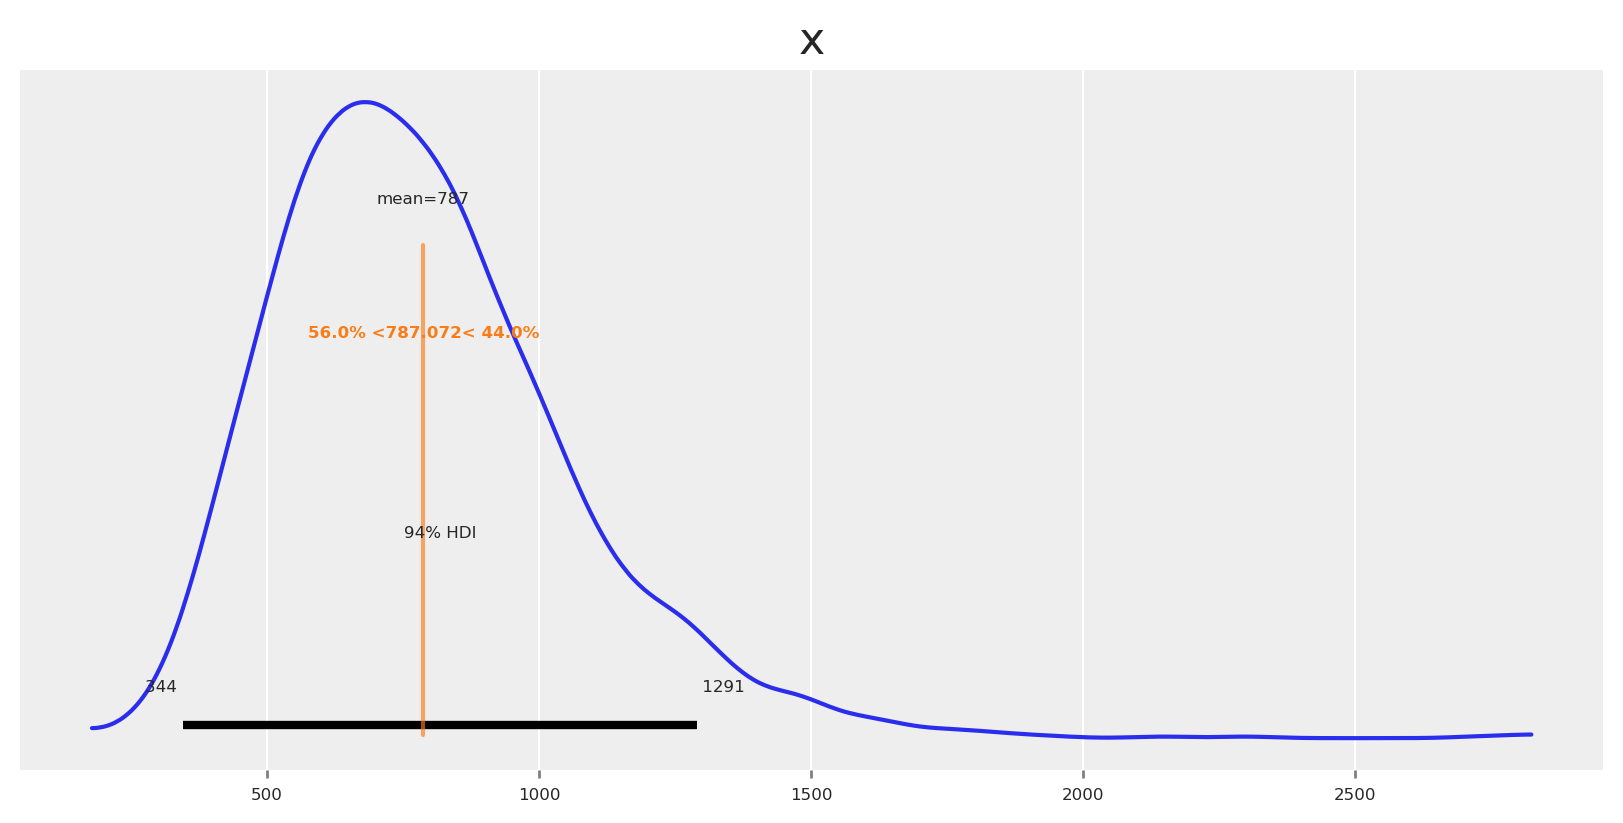
Como esperado, as médias diferem (otimizamos para as aumentar), e o mesmo acontece com a certeza em torno da média. Como exercício, vamos observar quão provável é obter uma resposta superior e inferior à média.
Isto torna tudo claro agora: as hipóteses de obter algo igual ou superior à média eram de 43%, mas as hipóteses de obter algo inferior à média eram de 56%. Não é surpresa que tenhamos obtido uma resposta mais baixa e um ROAS mais baixo.
💡 Primeira conclusão
Comparar distribuições completas torna o risco transparente: a largura quantifica a fiabilidade da previsão, a assimetria revela a assimetria entre vantagem e desvantagem, e as sobreposições mostram indistinguibilidade prática.
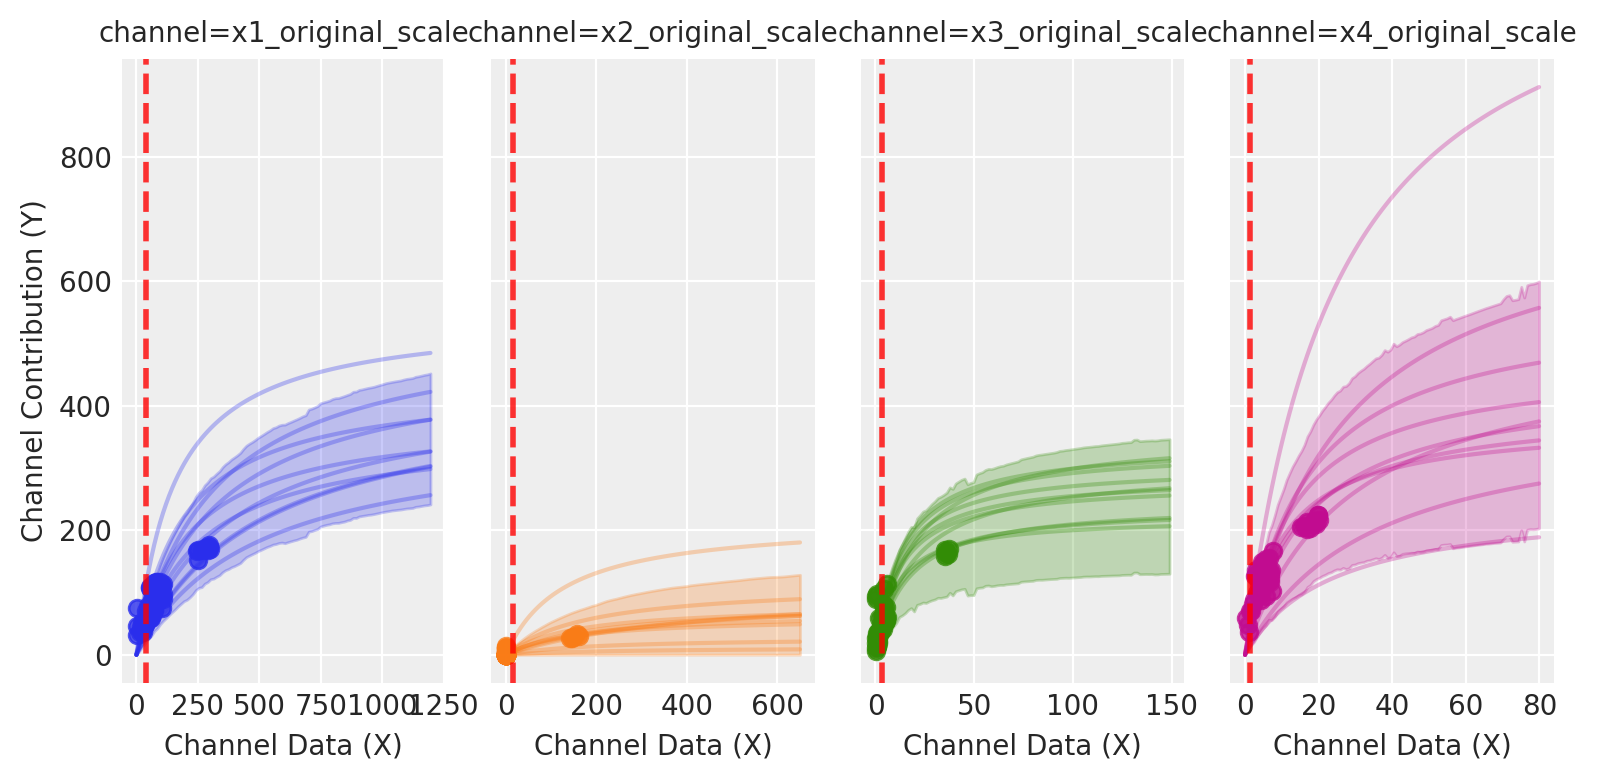
De onde vem este risco? A nova alocação é mais arriscada, mas porquê? Vamos olhar para cada nível de investimento relativamente à sua curva de saturação.
As linhas verticais estão localizadas na alocação de investimento atribuída a cada canal. Para canais como x4, o modelo tem poucas observações nesses níveis de investimento, pelo que as bandas a posteriori são largas e a distribuição de resposta induzida é difusa. A otimização sensível ao risco tende a puxar o investimento para regiões bem identificadas (frequentemente perto do ponto de inflexão), trocando uma pequena diminuição da média por uma grande redução da variância.
Será que poderíamos compreender isto com antecedência? E, em caso afirmativo, preferiríamos um tipo diferente de alocação? Que nos aproxima do nosso objetivo de forma mais segura? -Uma distribuição mais estreita com uma média ligeiramente mais baixa pode ser preferível quando o risco de insuficiência é oneroso-.
A resposta curta é decididamente. Vamos criar agora um novo processo de otimização que será sensível ao risco.
⚖️ Métricas de risco consistentes com PyMC-Marketing
Aqui utilizaremos uma aproximação heurística, mean tightness score implementada na biblioteca PyMC-Marketing. Esta pontuação combina a média com uma penalização pelo espalhamento das caudas.
🎯 Pontuação média de concentração (Mean Tightness Score)
Código
ut.mean_tightness_score?
O alpha aqui codifica o seu perfil de risco (intervalo 0-1); alocações com médias mais altas mesmo com grande dispersão pontuam melhor quando o seu alpha é alto. Quando o seu alpha é baixo, alocações com médias mais baixas mas pequena dispersão pontuam melhor.
Estamos a utilizar um alpha mais baixo no exemplo; como esperado, as recomendações para cada canal situam-se em regiões bem conhecidas.
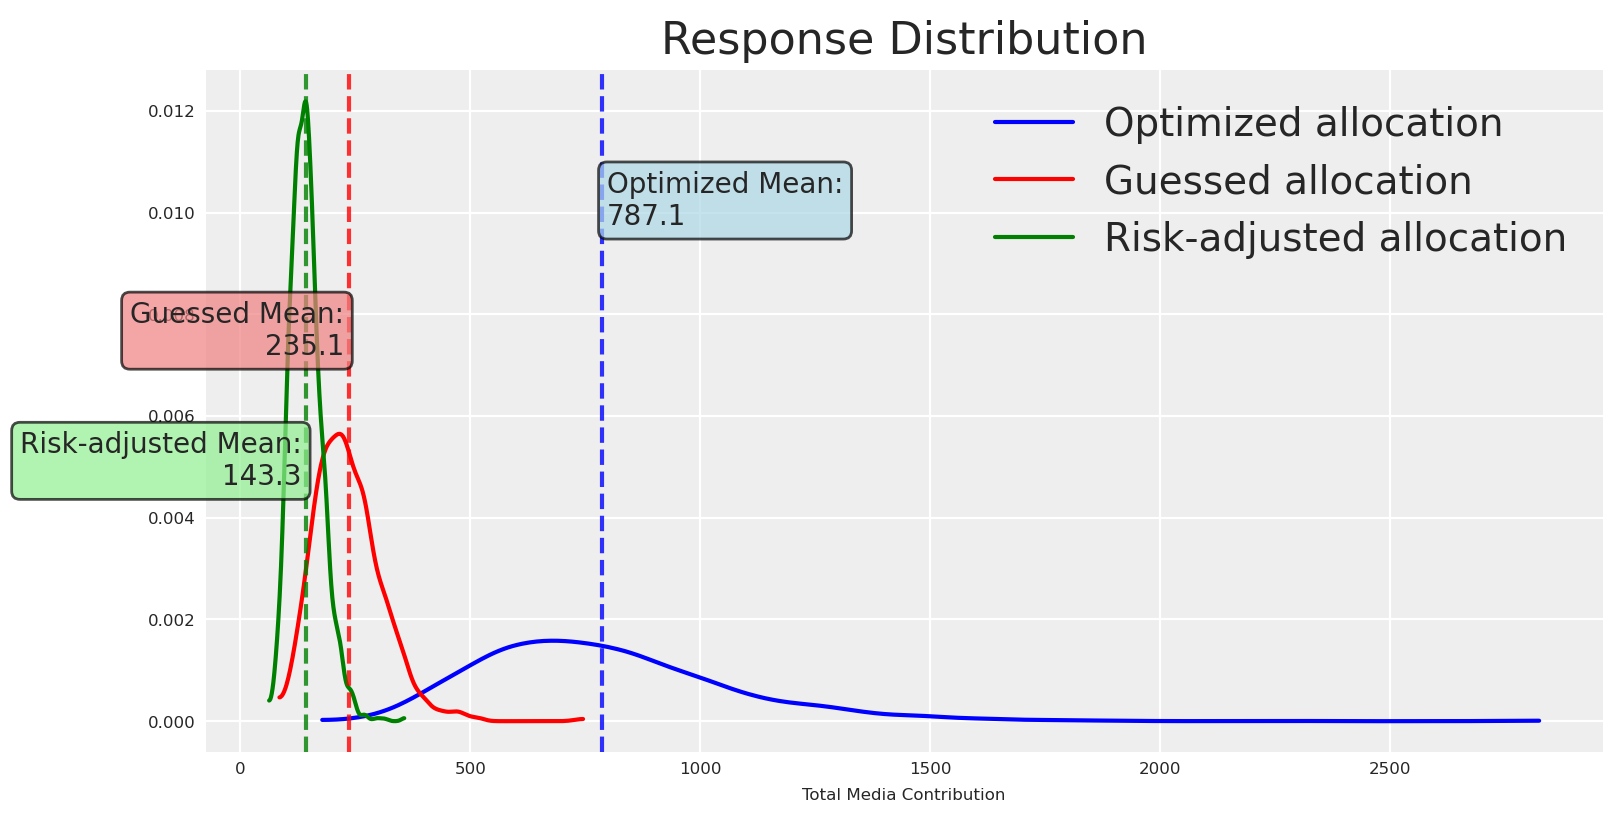
Isto torna claro: ganhámos muito mais certeza—uma distribuição de resposta avessa ao risco (menor variância). Pode estar a pensar que jogar em regiões conhecidas tende a reduzir a média. Quer saber porquê?
As curvas de resposta a posteriori tendem a ser mais certas na origem porque duas fontes de incerteza são minimizadas ali: estruturalmente, sabemos que zero investimento produz zero efeito incremental; e empiricamente, a região de menor investimento é frequentemente bem sustentada nos dados históricos. À medida que o investimento aumenta, especialmente além dos níveis observados historicamente, a incerteza epistémica sobre os parâmetros de saturação e curvatura domina, alargando os intervalos credíveis.
Significa isto que estamos condenados a valores mais baixos se quisermos certeza? De todo; podemos mudar a utilidade para preferir opções mais arriscadas 🔥.
Vamos executar uma alocação mais propensa ao risco 👀
Budget allocation by channel:
  x1_original_scale: 50
  x2_original_scale: 3
  x3_original_scale: 3
  x4_original_scale: 2
Total Allocated Budget: 59
Inverter a preferência de estreitamento (parâmetro alpha) induz comportamento propenso ao risco, deslocando as alocações para regiões de maior variância e alto potencial de valorização.
Agora escolhemos uma alocação menos certa mas com maior potencial de valorização do que a linha de base. Vamos representar as distribuições de resposta.
💡 Segunda conclusão
Descubra as suas preferências de risco e ajuste a sua função objetivo para as refletir. Não precisa de se comprometer com uma única função ou abordagem; pode construir uma personalizada que se adeque às suas necessidades.
Ótimo, a nova alocação é mais arriscada e a média é mais alta (ainda menos incerteza do que a alocação neutra ao risco). Podemos ir além das visualizações e quantificar isto.
Como todas são distribuições a posteriori, podemos verificar a densidade que cada distribuição de resposta tem na sua respetiva média. Utilizaremos a estimação de densidade por kernel (KDE). Este valor, denotado \hat{f}(\mu), representa a altura estimada da função de densidade de probabilidade na média. Importante, isto não é em si uma probabilidade mas sim uma densidade, com unidades de “1 sobre as unidades da variável.” Valores mais altos de \hat{f}(\mu) indicam que a distribuição é afilada em torno da refletindo maior certeza de que os sorteios a posteriori estarão próximos do valor central. Por outro lado, valores mais baixos correspondem a posteriores mais achatados e difusos, indicando maior incerteza.
Vamos verificar a densidade na média para cada alocação.
Código
from scipy.stats import gaussian_kdedef kde_density_at_point(x, x0):"""Gaussian KDE density estimate at x0 using Scott's rule bandwidth.""" kde = gaussian_kde(x) # Scott's rule by defaultreturnfloat(kde.evaluate([x0])[0])optimized_density = kde_density_at_point(optimized_values, optimized_mean)guessed_density = kde_density_at_point(guessed_values, guessed_mean)risk_adjusted_density = kde_density_at_point(optimized_risk_values, risk_adjusted_mean)inverse_risk_adjusted_density = kde_density_at_point(optimized_inverse_risk_values, inverse_risk_adjusted_mean)print(f"Optimized allocation response density at mean: {optimized_density:.3f}")print(f"Guessed allocation response density at mean: {guessed_density:.3f}")print(f"Risk-adjusted allocation response density at mean: {risk_adjusted_density:.3f}")print(f"Inverse Risk-adjusted allocation response density at mean: {inverse_risk_adjusted_density:.3f}")
Optimized allocation response density at mean: 0.001
Guessed allocation response density at mean: 0.005
Risk-adjusted allocation response density at mean: 0.012
Inverse Risk-adjusted allocation response density at mean: 0.010
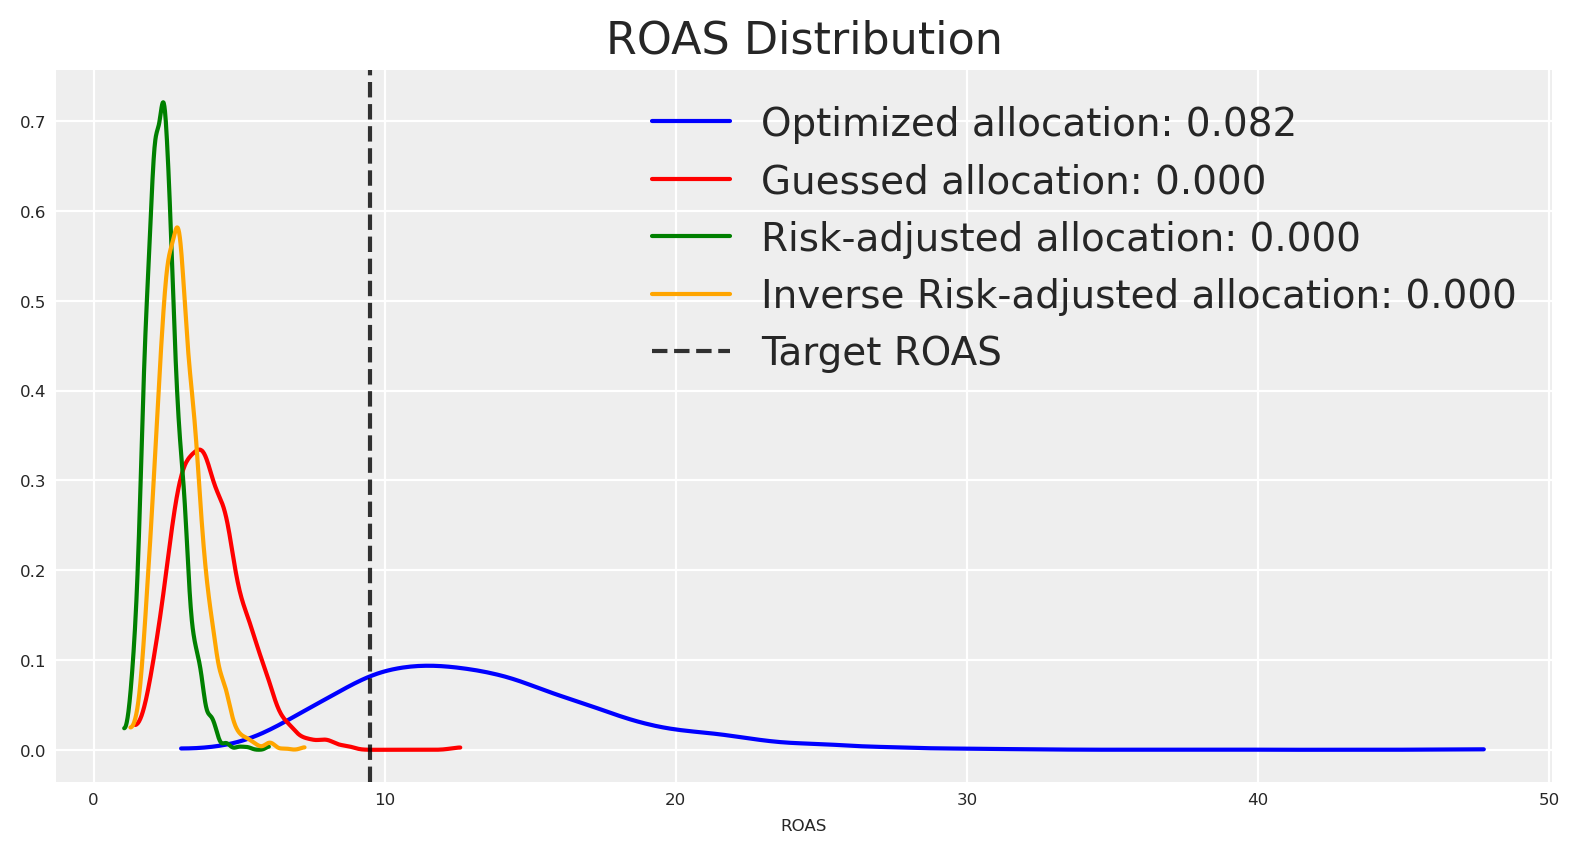
As estimativas de densidade contam a mesma história que os gráficos. Como podemos usar isto para tomar ações? Por exemplo, suponhamos que queremos atingir um ROAS alvo de 9.5; podemos então verificar a densidade da distribuição do ROAS em 9.5 para cada distribuição de resposta dada a sua respetiva estratégia de alocação.
Se quisermos atingir um ROAS alvo de 9.5, a alocação otimizada neutra ao risco é a mais certa, seguida pela alocação inversa ajustada ao risco.
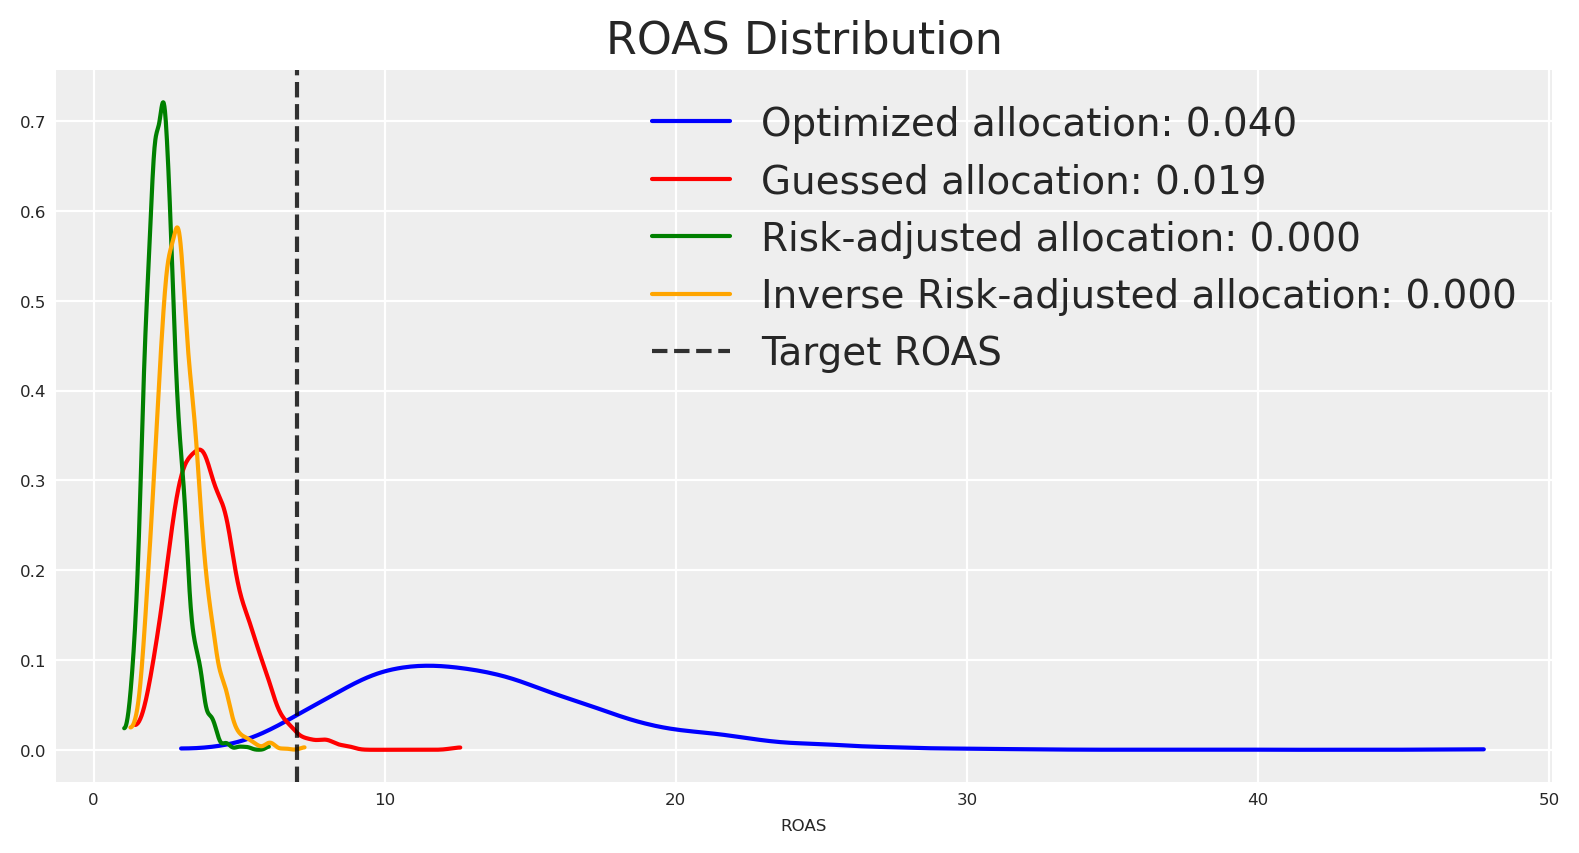
Se em vez disso o nosso ROAS alvo for 7, a alocação inversa ajustada ao risco concentra mais densidade em torno desse valor, e a alocação otimizada neutra ao risco tem menos densidade em torno dele.
Sob este paradigma, pode definir uma estimativa alvo e selecionar uma alocação que maximize a probabilidade de a atingir. Uma forma é criar uma função que reduza a variância em relação ao alvo, favorecendo distribuições mais estreitas com densidade perto do alvo.
Vamos criar esta função de utilidade personalizada e ver como se comporta.
Código
import pytensor.tensor as ptimport pymc_marketing.mmm.utility as utdef target_hit_probability(target, num_periods):""" Target hit probability utility function. Minimizing the mean squared error between predicted ROAS and the target Adding a variance penalty to encourage tighter distributions. Parameters ---------- target : float The target ROAS value to optimize towards num_periods : int Number of time periods for the budget allocation Returns ------- callable A utility function that can be used with the budget optimizer. Returns negative objective (since optimizer minimizes). """def _function(samples, budgets): roas_samples = samples / (pt.sum(budgets) * num_periods)# Use mean squared error from target, which provides smoother gradients mse_from_target = pt.mean((roas_samples - target) **2)# Add penalty for variance to encourage tighter distributions around target variance_penalty = pt.var(roas_samples)# Combine MSE and variance penalty with weighting# Higher variance penalty encourages narrower distributions total_objective = mse_from_target +0.1* variance_penaltyreturn-total_objectivereturn _function_roas_target =10custom_utility_budget_allocation, custom_utility_optimizer_result, callback_results = ( optimizable_model.optimize_budget( budget=time_unit_budget, utility_function=target_hit_probability(_roas_target, num_periods), callback=True, minimize_kwargs={"options": {"maxiter": 2_000}}, ))custom_utility_posterior_response = optimizable_model.sample_response_distribution( allocation_strategy=custom_utility_budget_allocation, include_carryover=True, include_last_observations=False, additional_var_names=["y_original_scale"])# Print budget allocation by channelprint("Budget allocation by channel:")for channel in channels:print(f" {channel}: {custom_utility_posterior_response.allocation.sel(channel=channel).astype(int).sum():,}" )print(f"Total Allocated Budget: {np.sum(custom_utility_posterior_response.allocation.to_numpy()):,.0f}")
Budget allocation by channel:
  x1_original_scale: 23
  x2_original_scale: 0
  x3_original_scale: 23
  x4_original_scale: 12
Total Allocated Budget: 59
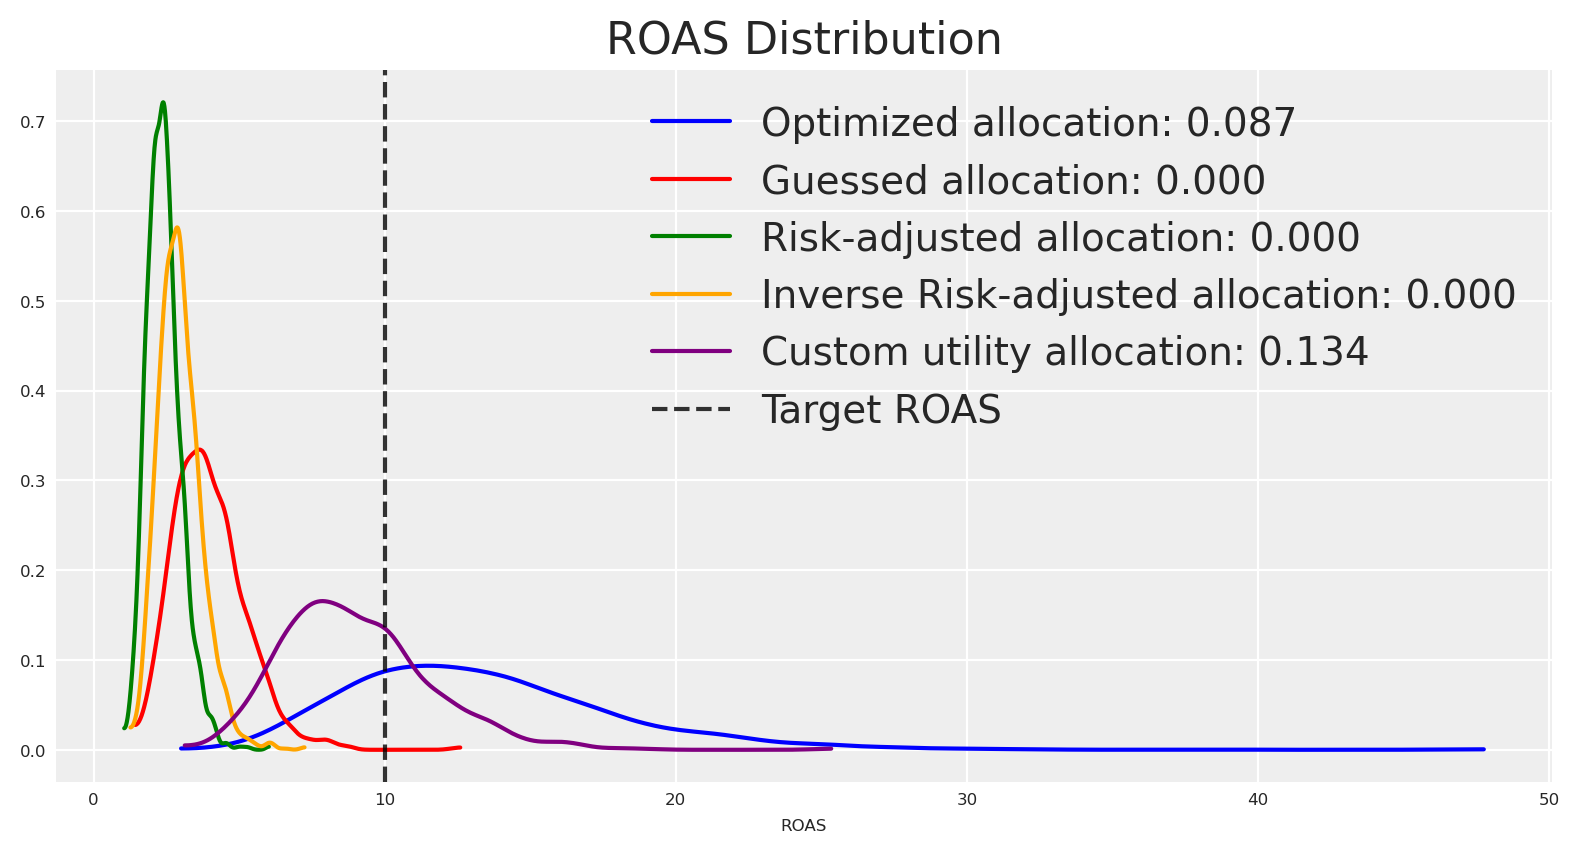
A alocação é semelhante às observadas anteriormente. Vamos representar as distribuições de ROAS.
Ótimo 🙌🏻 A alocação otimizada inicial, que era neutra ao risco, tinha inicialmente a maior densidade em torno do ROAS alvo, mas a densidade não era suficientemente alta; a nova alocação traz uma resposta mais certa em torno do alvo, porque a função objetivo foi construída para isso.
💡 Ideia-chave
Aqui temos uma função de utilidade personalizada que nos permite otimizar para um ROAS alvo. No entanto, pode construir outras utilidades e usá-las como objetivos. Pode também introduz restrições sensíveis ao risco—sem sobrepor às suas restrições de negócio.
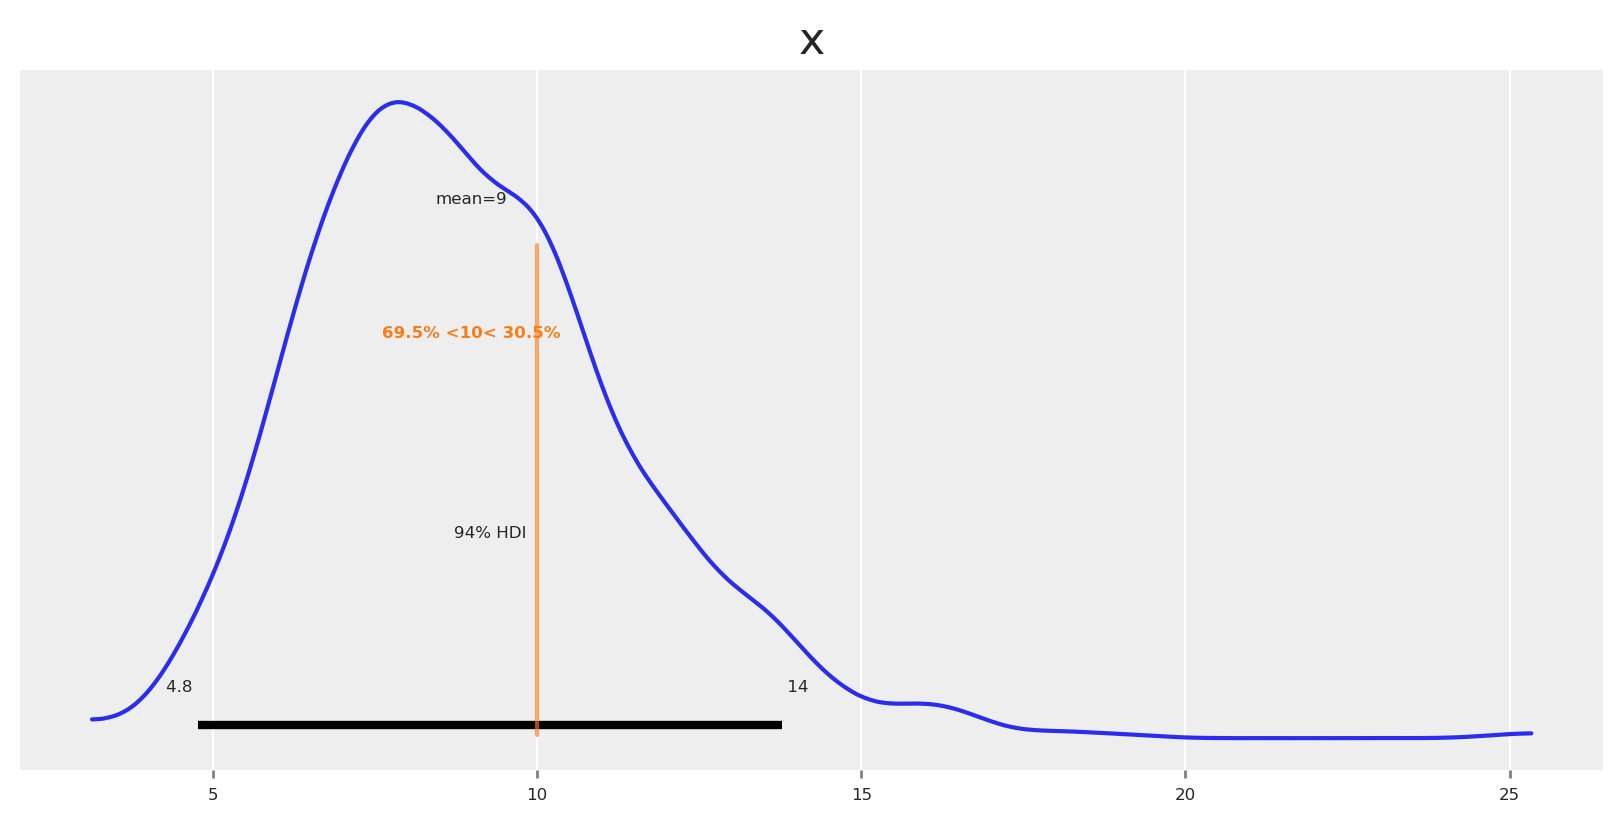
Vamos observar o nosso posterior final em torno do ROAS alvo.
Podemos dizer: a probabilidade de alcançar ROAS ≥ 10 com esta alocação é de 31%, e ROAS < 10 é de 69%. Se precisarmos de mais certeza, podemos tornar a otimização mais avessa ao risco.
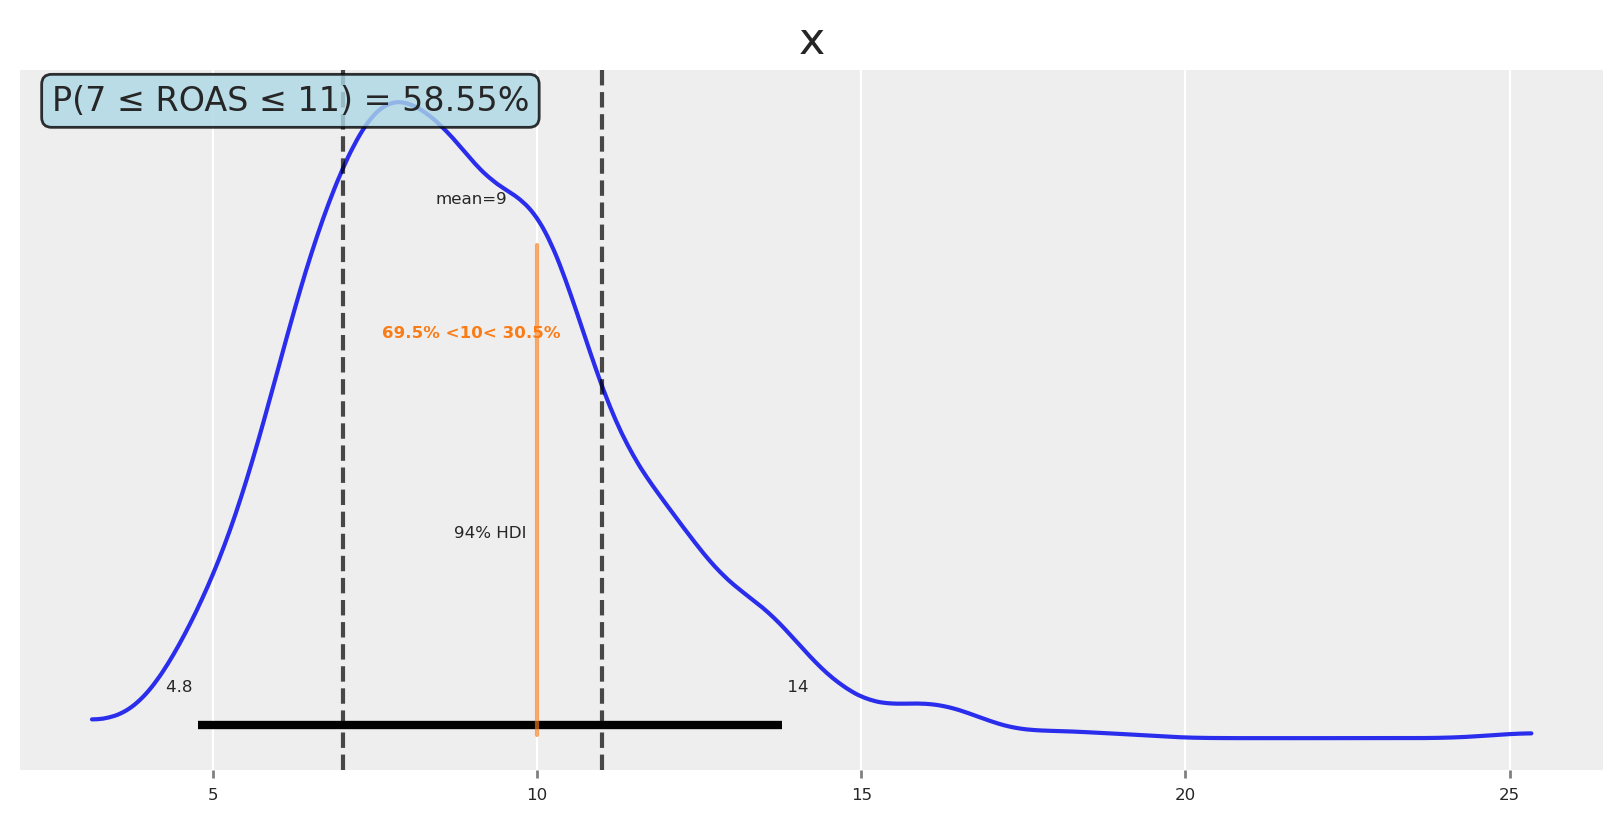
Agora, se quiser pensar de forma realmente bayesiana, pode definir uma região de equivalência prática e verificar a probabilidade de o ROAS estar nessa região. Por exemplo, pode perguntar-se: Faria algo diferente se o ROAS fosse 7, 9 ou 11? Se a resposta for não, então encontrou a sua ROPE.
Suponhamos que queremos saber a probabilidade de o ROAS estar entre 7 e 11.
Código
# Calculate probability of ROAS being between 7 and 9prob_7_to_11 = np.mean((custom_utility_roas >=7) & (custom_utility_roas <=11))# Plot posterior with reference values and regionfig, ax = plt.subplots()az.plot_posterior( custom_utility_roas, ref_val=_roas_target, ax=ax)# Add vertical lines for the region of interestax.axvline(7, color="black", linestyle="--", alpha=0.7, label="ROAS = 7")ax.axvline(11, color="black", linestyle="--", alpha=0.7, label="ROAS = 11")# Add text box with probabilityax.text(0.02, 0.98, f'P(7 ≤ ROAS ≤ 11) = {prob_7_to_11:.2%}', transform=ax.transAxes, bbox=dict(boxstyle="round,pad=0.3", facecolor="lightblue", alpha=0.8), ha='left', va='top', fontsize=12)plt.show()
💡 Ideia-chave
Pode definir uma região de equivalência prática (ROPE), de forma a ser mais preciso nas suas decisões. Esta é uma forma bastante natural de pensar sobre um problema, e alivia o fardo do decisor de se comprometer com um único número. No final do dia, não precisamos de ser 99.999% precisos em torno de cada resposta ou número; podemos ser 95% ou 90% precisos e por vezes isso é suficiente. Identifique se esse é o seu caso, e pense em conformidade.
✅ Conclusões sobre incerteza
Trate a incerteza como primordial: Otimize sobre a preditiva a posteriori completa, não estimativas pontuais. Compare planos pelas suas distribuições, não apenas pelas médias esperadas.
Compreenda os tipos de incerteza: Aleatória (ruído irreductível) vs epistémica (incerteza aprendível do modelo/parâmetros). As escolhas de planeamento deslocam sobretudo o risco epistémico; comunique sempre ambos.
Descubra o seu apetite para o risco: Pergunte às partes interessadas quão certos precisamos de estar sobre os resultados reportados. O que muda se forem um pouco mais altos ou mais baixos?
Escolha uma utilidade alinhada com o apetite para o risco: Trabalhar com a média é neutro ao risco; quantis, TailDistance, CVaR ou MTS são mais sensíveis ao risco.
Comunique distribuições, não números isolados: Apresente HDIs/quantis e probabilidades (ex., P(ROAS ≥ alvo)). É melhor compreender o espetro completo de possibilidades do que seguir números isolados e ter uma visão de curto prazo.
Defina uma região de equivalência prática (ROPE): Quando já se sentir confortável com a incerteza, explore ROPEs e descubro quanto pode aligeirar a resposta estimada, e se faria algo diferente se esta mudasse dentro de um intervalo de valores.
🚧 Limitações
Esta abordagem reflete a confiança do modelo, mas os modelos podem estar muito certos de uma resposta errada. Adicione sempre conhecimento do negócio e salvaguardas para manter as recomendações realistas.
Conclusão
Espero que este artigo tenha sido útil para compreender como usar modelos bayesianos de media mix para otimizar o seu investimento em media. Compreender a incerteza é uma ferramenta poderosa para tomar melhores decisões, mas não é uma solução milagrosa.
O exemplo atual é simples; as aplicações da vida real são mais complexas e requerem modelos mais sofisticados, funções de risco e problemas de otimização complexos, onde as restrições e o conhecimento do negócio são fundamentais.
Na PyMC Labs estamos a construir ferramentas para tornar este processo mais fácil. Se estiver interessado em saber mais, explore a Galeria de Exemplos e a API do PyMC‑Marketing, a nossa documentação e o blog.
Pode obter uma consulta gratuita de 30 minutos com a nossa equipa para discutir as suas necessidades específicas e como podemos ajudá-lo.
---title: "Bayesian Models and Risk Optimization"author: "Carlos Trujillo"date: "2025-08-20"description: "Bayesian models and risk optimization for marketing budgets, presented at PyData Berlin 2025."categories: [MMM, python, optimization, media mix modeling, bayesian, pymc, pydata, germany, berlin]image: "/images/bayesian_models_and_risk_optimization.jpg"image-alt: "Bayesian model risk optimization visualization for marketing budget allocation"jupyter: bayesian_models_and_risk_optimizationformat: html: code-fold: true code-tools: true code-overflow: wrap---# 📘 IntroductionThis article explores how Bayesian Media Mix Modeling (MMM) represents uncertainty and how we can optimize budget decisions under risk. We build a generative view of media response (carryover via adstock, diminishing returns via saturation, trend and seasonality) and use full posterior predictive distributions to compare allocations not only by expected outcomes but also by dispersion and tail risk.This material accompanies my PyData Berlin 2025 talk, where I discuss practical risk-aware optimization for MMM: moving beyond mean-only plans to objectives that explicitly incorporate uncertainty—and how to communicate these trade-offs to stakeholders.# 📦 Import libraries```{python}#| warning: falseimport warningswarnings.filterwarnings("ignore", category=UserWarning)from pymc_marketing.mmm.builders.yaml import build_mmm_from_yamlfrom pymc_marketing.mmm import GeometricAdstock, MichaelisMentenSaturationfrom pymc_marketing.mmm.budget_optimizer import optimizer_xarray_builderfrom pymc_marketing.mmm.multidimensional import ( MultiDimensionalBudgetOptimizerWrapper,)from pymc_extras.prior import Priorfrom pymc_marketing.mmm import utility as utfrom scipy import ndimageimport arviz as azimport matplotlib.pyplot as pltimport seaborn as snsimport numpy as npimport pandas as pdimport xarray as xr```# ⚙️ Notebook setup ```{python}#| warning: falseaz.style.use("arviz-darkgrid")plt.rcParams["figure.figsize"] = [8, 4]plt.rcParams["figure.dpi"] =100plt.rcParams["axes.labelsize"] =6plt.rcParams["xtick.labelsize"] =6plt.rcParams["ytick.labelsize"] =6plt.rcParams.update({"figure.constrained_layout.use": True})%load_ext autoreload%autoreload 2seed: int=sum(map(ord, "pydata_berlin_2025"))rng: np.random.Generator = np.random.default_rng(seed=seed)default_figsize = (8, 4) # repeat to use later```# 🧪 Data generation process We simulate outcomes as$$y_t = \beta_0 + \sum_{c} f(x_{c,t}; \theta_c) + \text{trend}_t + \text{seasonality}_t + \varepsilon_t$$where:- $y_t$ is the observed outcome (e.g., app installs or revenue) at time $t$- $\beta_0$ is the baseline intercept- $f(x_{c,t}; \theta_c)$ is the media response function for channel $c$ with spend $x_{c,t}$ and parameters $\theta_c$.- $\text{trend}_t$ captures long-term growth or decline patterns- $\text{seasonality}_t$ models periodic effects (weekly, monthly patterns)- $\varepsilon_t$ represents aleatoric uncertainty—irreducible noise from unobserved factors, measurement error, and inherent randomness that remains even with perfect knowledge of all parametersWe do not consider interactions; the causal DAG looks like this:```{python}#| warning: falseimport graphvizgraph = graphviz.Digraph()graph.node("Media Spend")graph.node("Trend", style="dashed")graph.node("Seasonality", style="dashed")graph.node("Target")graph.edge("Media Spend", "Target")graph.edge("Trend", "Target")graph.edge("Seasonality", "Target")graph```## 📆 Date rangeWe start by defining the date range.```{python}#| warning: false# date rangemin_date = pd.to_datetime("2024-09-01")max_date = pd.to_datetime("2025-09-01")df = pd.DataFrame( data={"date_week": pd.date_range(start=min_date, end=max_date, freq="W-MON")})n = df.shape[0]print(f"Number of observations: {n}")print("Date Range: {} to {}".format(df.date_week.min(), df.date_week.max()))```## 📣 Media data```{python}#| warning: false# media datascaler_x1 =300scaler_x2 =280scaler_x3 =50scaler_x4 =100y_scaler =1000# media datax1 = rng.uniform(low=0.0, high=1.0, size=n)df["x1"] = np.where(x1 >0.8, x1, x1 /2)x2 = rng.uniform(low=0.0, high=0.6, size=n)df["x2"] = np.where(x2 >0.5, x2, 0)x3 = rng.uniform(low=0.0, high=0.8, size=n)df["x3"] = np.where(x3 >0.7, x3, x3 /6)x4 = rng.uniform(low=0.0, high=0.2, size=n)df["x4"] = np.where(x4 >0.15, x4, x4 /2)fig, ax = plt.subplots( nrows=4, ncols=1, sharex=True, sharey=True, layout="constrained")sns.lineplot(x="date_week", y="x1", data=df, color="C0", ax=ax[0])sns.lineplot(x="date_week", y="x2", data=df, color="C1", ax=ax[1])sns.lineplot(x="date_week", y="x3", data=df, color="C2", ax=ax[2])sns.lineplot(x="date_week", y="x4", data=df, color="C3", ax=ax[3])ax[3].set(xlabel="date")fig.suptitle("Media Costs Data", fontsize=16);```## 📈 Trend and seasonality componentsWe define trend and seasonality. Seasonality follows a 4-week cycle modeled with a Fourier basis; trend is linear.```{python}#| warning: false# Create Fourier components for monthly seasonalitymonthly_period =4# 4-week cyclet = np.arange(n)# Create sin-cos signals for fourier componentsmonthly_sin = np.sin(2* np.pi * t / monthly_period)monthly_cos = np.cos(2* np.pi * t / monthly_period)# Combine sin-cos to create the desired pattern# Use coefficients to shape the patternmonthly_pattern =0.6* monthly_sin +0.4* monthly_cos# Apply smoothing using ndimage to reduce sharp transitionsmonthly_pattern = ndimage.gaussian_filter1d(monthly_pattern, sigma=0.2)# Normalize to [-1, 1] rangemonthly_pattern = (monthly_pattern / np.max(np.abs(monthly_pattern))) *.18df["monthly_effect"] = monthly_patterndf["trend"] = (np.linspace(start=0.0, stop=10, num=n) +10) ** (1/8) -1fig, (ax1, ax2) = plt.subplots(2, 1, sharex=True)# Plot monthly patternax1.plot(df["date_week"], monthly_pattern, label="Monthly Pattern (Smoothed)", linewidth=2, color='blue')ax1.set_ylabel("Pattern Value")ax1.set_title("Monthly Fourier Pattern (4-week cycle, Smoothed)")ax1.grid(True, alpha=0.3)ax1.legend()# Plot trendax2.plot(df["date_week"], df["trend"], label="Trend", linewidth=2, color='red')ax2.set_xlabel("Date")ax2.set_ylabel("Trend Value")ax2.set_title("Linear Trend Component")ax2.grid(True, alpha=0.3)ax2.legend()plt.tight_layout()plt.show()```## 🔁 Adstock and saturation transformationsFirst, we apply the adstock transformation to the media data.```{python}#| warning: false# apply geometric adstock transformationalpha: float=0.55df["x1_adstock"] = ( GeometricAdstock(l_max=8, normalize=True).function(x=df["x1"].to_numpy(), alpha=alpha) .eval())df["x2_adstock"] = ( GeometricAdstock(l_max=8, normalize=True).function(x=df["x2"].to_numpy(), alpha=alpha) .eval())df["x3_adstock"] = ( GeometricAdstock(l_max=8, normalize=True).function(x=df["x3"].to_numpy(), alpha=alpha) .eval())df["x4_adstock"] = ( GeometricAdstock(l_max=8, normalize=True).function(x=df["x4"].to_numpy(), alpha=alpha) .eval())df.head()```Then we apply the saturation transformation to the adstock transformed media data.```{python}#| warning: falsealpha_sat_x1: float=0.3lam_sat_x1: float=1.1alpha_sat_x2: float=0.1lam_sat_x2: float=1.5alpha_sat_x3: float=0.2lam_sat_x3: float=0.3alpha_sat_x4: float=0.8lam_sat_x4: float=0.8df["x1_adstock_saturated"] = ( MichaelisMentenSaturation().function( x=df["x1_adstock"].to_numpy(), alpha=alpha_sat_x1, lam=lam_sat_x1, ).eval())df["x2_adstock_saturated"] = ( MichaelisMentenSaturation().function( x=df["x2_adstock"].to_numpy(), alpha=alpha_sat_x2, lam=lam_sat_x2, ).eval())df["x3_adstock_saturated"] = ( MichaelisMentenSaturation().function( x=df["x3_adstock"].to_numpy(), alpha=alpha_sat_x3, lam=lam_sat_x3, ).eval())df["x4_adstock_saturated"] = ( MichaelisMentenSaturation().function( x=df["x4_adstock"].to_numpy(), alpha=alpha_sat_x4, lam=lam_sat_x4, ).eval())df.head()```Let's visualize how the media data look after adstock and saturation, and how they translate into units of Y (app installs or revenue).```{python}#| warning: falsefig, ax = plt.subplots( nrows=3, ncols=4, sharex=True, sharey=False, layout="constrained")sns.lineplot(x="date_week", y="x1", data=df, color="C0", ax=ax[0, 0])sns.lineplot(x="date_week", y="x2", data=df, color="C1", ax=ax[0, 1])sns.lineplot(x="date_week", y="x1_adstock", data=df, color="C0", ax=ax[1, 0])sns.lineplot(x="date_week", y="x2_adstock", data=df, color="C1", ax=ax[1, 1])sns.lineplot(x="date_week", y="x1_adstock_saturated", data=df, color="C0", ax=ax[2, 0])sns.lineplot(x="date_week", y="x2_adstock_saturated", data=df, color="C1", ax=ax[2, 1])sns.lineplot(x="date_week", y="x3", data=df, color="C2", ax=ax[0, 2])sns.lineplot(x="date_week", y="x3_adstock", data=df, color="C2", ax=ax[1, 2])sns.lineplot(x="date_week", y="x3_adstock_saturated", data=df, color="C2", ax=ax[2, 2])sns.lineplot(x="date_week", y="x4", data=df, color="C3", ax=ax[0, 3])sns.lineplot(x="date_week", y="x4_adstock", data=df, color="C3", ax=ax[1, 3])sns.lineplot(x="date_week", y="x4_adstock_saturated", data=df, color="C3", ax=ax[2, 3])fig.suptitle("Media Costs Data - Transformed", fontsize=16);```We now add the intercept and noise, and sum the transformed media, trend, and seasonality components.```{python}#| warning: falsedf["intercept"] =0.15df["epsilon"] = rng.normal(loc=0.0, scale=0.075, size=n)df["app_installs"] = df[["intercept", "x1_adstock_saturated", "x2_adstock_saturated", "x3_adstock_saturated", "x4_adstock_saturated", "trend", "monthly_effect", "epsilon"]].sum(axis=1)df["app_installs"] *= y_scalerdf.head()```This is how the target looks.```{python}#| warning: falsedf.set_index("date_week").app_installs.plot();```We also add the original media to the DataFrame so we can visualize it before any transformations and use it as model input.```{python}#| warning: falsedf[["x1_original_scale", "x2_original_scale", "x3_original_scale", "x4_original_scale"]] = df[["x1", "x2", "x3", "x4"]]df["x1_original_scale"] *= scaler_x1df["x2_original_scale"] *= scaler_x2df["x3_original_scale"] *= scaler_x3df["x4_original_scale"] *= scaler_x4df[["date_week", "x1_original_scale", "x2_original_scale", "x3_original_scale", "app_installs"]].head()```# 🏗️ Building the modelThe YAML configuration encodes a fully Bayesian MMM with priors over the core response mechanics and temporal structure. For model specifics and worked examples, see the PyMC‑Marketing [Example Gallery](https://www.pymc-marketing.io/en/stable/gallery/gallery.html) and [API](https://www.pymc-marketing.io/en/stable/api/index.html).Here we split the data into train and test sets. Not to evaluate the fit; instead, we use the test set to compare the results of the optimization, checking if it will be "better" than the budget recommendations than the actual/current plan.```{python}#| warning: falsedf_train = df.query("date_week <= '2025-08-30'").copy()x_train = df_train[["date_week", "x1_original_scale", "x2_original_scale", "x3_original_scale", "x4_original_scale"]]y_train = df_train["app_installs"]df_test = df.query("date_week > '2025-08-30'").copy()x_test = df_test[["date_week", "x1_original_scale", "x2_original_scale", "x3_original_scale", "x4_original_scale"]]y_test = df_test["app_installs"]```Because the model was defined previously in the YAML, building it is straightforward and takes only a few lines.```{python}#| warning: falsemmm = build_mmm_from_yaml( X=x_train, y=y_train, config_path="pymc_model.yml",)```Now we fit the model and check convergence!```{python}#| warning: falsemmm.fit( X=x_train, y=y_train, random_seed=rng,)mmm.sample_posterior_predictive( X=x_train, extend_idata=True, combined=True, random_seed=rng,)```Great, no divergences 🔥```{python}#| warning: falsemmm.idata.sample_stats.diverging.sum().item()```We can inspect the parameters relevant for optimization.```{python}#| warning: falsemedia_vars = ["saturation_alpha","saturation_lam","adstock_alpha",]_ = az.plot_trace( data=mmm.fit_result, var_names=media_vars, compact=True, backend_kwargs={"figsize": default_figsize, "layout": "constrained"},)plt.gcf().suptitle("Model Trace", fontsize=16, fontweight="bold", y=1.03);```As expected, some parameters are well identified while others remain uncertain.Sampling saturation curves from the posterior helps us visualize parameter uncertainty as bands around each channel’s response. Wide bands indicate poorly identified marginal returns; allocating in those regions increases outcome variance because small parameter shifts cause large changes in response.```{python}#| warning: falsecurve = mmm.saturation.sample_curve( mmm.idata.posterior[["saturation_alpha", "saturation_lam"]], max_value=3)fig, axes = mmm.plot.saturation_curves( curve, original_scale=True, n_samples=10, hdi_probs=0.85, random_seed=rng, subplot_kwargs={"figsize": default_figsize, "ncols": 4, "sharey": True}, rc_params={"xtick.labelsize": 10,"ytick.labelsize": 10,"axes.labelsize": 10,"axes.titlesize": 10, },)for ax in axes.ravel(): ax.title.set_fontsize(10)if fig._suptitle isnotNone: fig._suptitle.set_fontsize(12)plt.tight_layout()plt.show()```The picture is clear: channels like X1 and X3 exhibit more variation across spend levels, allowing the model to learn their parameters more precisely. Channels like X2 and X4 have relatively constant spending with less variation, so their parameters are estimated with greater uncertainty.# 🎲 Understanding uncertaintyIn a Bayesian MMM we explicitly model two forms of uncertainty that compound in forecasts and in budget decisions:- Aleatoric uncertainty: randomness in outcomes conditional on fixed parameters. In the simulation, this is `epsilon`. Formally, if parameters are $\theta$, aleatoric uncertainty is the spread of $p(y\mid x,\theta)$ once we model the likelihood as $\mathcal{N}(0, \sigma^2)$. In our model, the parameter $\sigma$ explicitly captures aleatoric uncertainty: it quantifies the amount of outcome variability that remains even if all structural parameters $\theta$ were known exactly. It represents inherent unpredictability due to unobserved micro-variation, demand shocks, or logging noise. Even with infinite data, aleatoric uncertainty remains.- Epistemic uncertainty: uncertainty about the parameters and latent functions themselves due to limited or weakly informative data. This is the spread of the posterior $p(\theta\mid \text{data})$. It shrinks with more data, better priors, or richer experimental variation. In our model it includes carryover memory (adstock $\alpha$), saturation curvature and half-saturation (Michaelis–Menten $\alpha,\lambda$), trend slopes, and seasonal Fourier weights.Why this separation matters for planning:1) Outcome distribution under a plan. For a given allocation plan $b$ over channels and time, the posterior predictive is$$p\big(Y(b)\mid \text{data}\big) = \int p\big(Y(b)\mid \theta\big)\, p(\theta\mid \text{data})\, d\theta,$$which mixes aleatoric variability (the inner term) and epistemic variability (integration over $\theta$). Our Monte Carlo estimator samples $\theta^{(s)}$ from the posterior, simulates carryover and saturation under $b$, and draws predictive outcomes.2) Example: known vs unknown curvature. Suppose a channel’s saturation is well learned around historical spends but not beyond. Two plans with the same total spend differ in risk: - Plan A concentrates around the historical mode (epistemic low), yielding a narrow predictive distribution. - Plan B pushes beyond observed spends (epistemic high), producing a wider distribution and heavier downside tails if the curve flattens earlier than hoped.During optimization, we focus on the second component —epistemic uncertainty— and can choose how much confidence we require around it. Once we choose an allocation, then we incorporate aleatoric uncertainty to quantify the total response distribution, if we want to.# 🧭 OptimizationLets thing about our model and their outputs, starting with the posterior predictive distribution:$$p\big(Y(b)\mid \text{data}\big) = \int p\big(Y(b)\mid \theta\big)\, p(\theta\mid \text{data})\, d\theta$$As you can see, the posterior predictive distribution incorporates both aleatoric and epistemic uncertainty, meaning, the optimization problem reduces to choosing an allocation $b$ that optimizes a scalar summary of this distribution.Formally, let $b \in \mathbb{R}^C$ denote a feasible allocation (e.g., channel budgets) with constraints$$\sum_{c=1}^C b_c = B, \qquad \underline{b}_c \leq b_c \leq \overline{b}_c.$$For each candidate allocation $b$, we obtain Monte Carlo draws from the posterior predictive distribution:$$\{Y^{(s)}(b)\}_{s=1}^S \sim p(Y \mid \mathrm{do}(X=b), \mathcal{D}),$$A statistic is then computed (for example, the mean, a quantile, a risk-adjusted score, or the mean tightness score). $$\phi\!\left(\{Y^{(s)}(b)\}\right)$$ By consequence, the optimization problem solved by SLSQP is simply$$\min_{b \in \mathcal{B}} J(b), \qquad J(b) = f\!\left(\phi(\{Y^{(s)}(b)\})\right),$$where $f$ is defined so the solver minimizes the chosen statistic from the posterior predictive distribution. This formulation is flexible: by changing $\phi$, we can target risk-neutral or risk-sensitive criteria or even heuristics, while always grounding the decision in the posterior predictive distribution.::: {.callout-note}## 💡 Assumption notesWhy do we say do=$(X=b)$?- **Structural invariance**: The response functions (trend, seasonality, adstock, saturation, link) are invariant under interventions $b$ over the optimization horizon.- **No unmeasured confounding**: Conditional on included covariates and time controls, there are no unmeasured (especially time-varying) confounders affecting both spend and outcome; the backdoor criterion holds.We use $p\big(Y \mid \mathrm{do}(X=b), \mathcal{D}\big)$ as shorthand for the posterior predictive under these assumptions. When allocations move far outside support, results become extrapolative and should be treated as sensitivity analysis rather than identified effects.:::::: {.callout-warning}## 👀 Really bayesian?Our approach differs from “Bayesian optimization” in the ML sense (which sequentially models the objective with a surrogate and optimizes an acquisition function). In contrast, we already have the full posterior $p(\theta \mid \text{data})$, which we propagate into the posterior predictive $p(Y(b)\mid \text{data})$. The optimization then operates on a scalar functional $\phi$ of this distribution. This can be viewed as a compression of the posterior predictive into a decision-relevant summary, but not as a loss of Bayesian information. The optimization remains fully Bayesian because the criterion depends entirely on posterior draws.:::## 🛠️ Define the optimizerInitializing the optimizer is straightforward: pass the model and the date range.```{python}#| warning: falseoptimizable_model = MultiDimensionalBudgetOptimizerWrapper( model=mmm, start_date=df_test.date_week.min().strftime("%Y-%m-%d"), end_date=df_test.date_week.max().strftime("%Y-%m-%d"))print(f"Start date: {optimizable_model.start_date}")print(f"End date: {optimizable_model.end_date}")```We'll use the test set to define the budget and optimization period so we can compare the resulting allocation to our current plan.```{python}#| warning: false channels = ["x1_original_scale", "x2_original_scale", "x3_original_scale", "x4_original_scale"]num_periods = optimizable_model.num_periodstime_unit_budget = df_test[channels].sum(axis=1).mean()print(f"Total budget to allocate: {num_periods * time_unit_budget:,.0f}")```Given the budget and channels, we can estimate the response for our initial plan.```{python}#| warning: falseinitial_budget = df_test[channels].sum(axis=0).to_xarray().rename({"index":"channel"})initial_posterior_response = optimizable_model.sample_response_distribution( allocation_strategy=initial_budget, include_carryover=True, include_last_observations=False, additional_var_names=["y_original_scale"])fig, ax = optimizable_model.plot.budget_allocation( samples=initial_posterior_response, figsize=default_figsize,)```The default `plot.budget_allocation` makes a bar chart with allocation and response per channel. In order to see totals, we can sum and create a simple scatter plot with a label for the ROAS.```{python}#| warning: false# Create scatterplot with spend and mean responsespend = initial_posterior_response.allocation.sum().valuesmean_response = initial_posterior_response.total_media_contribution_original_scale.mean(dim='sample').valuesinitial_roas = mean_response / spendplt.scatter(spend, mean_response, alpha=0.7, s=100, label=f"ROAS: {initial_roas:.2f}")plt.xlabel('Spend')plt.ylabel('Mean Response')plt.title('Spend vs Mean Response')plt.grid(True, alpha=0.3)plt.legend(fontsize='small', loc='upper left')plt.show()```We got a ROAS of $3.9$ for the initial plan, which is below our target ROAS (let's say $8$). Now we can run a vanilla optimization to response the question: **can we reallocate to achieve a higher response given the same budget?**```{python}#| warning: falseallocation_strategy, optimization_result = optimizable_model.optimize_budget( budget=time_unit_budget,)naive_posterior_response = optimizable_model.sample_response_distribution( allocation_strategy=allocation_strategy, include_carryover=True, include_last_observations=False, additional_var_names=["y_original_scale"])print("Budget allocation by channel:")for channel in channels:print(f" {channel}: {naive_posterior_response.allocation.sel(channel=channel).astype(int).sum():,}" )print(f"Total Allocated Budget: {np.sum(naive_posterior_response.allocation.to_numpy()):,.0f}")fig, ax = optimizable_model.plot.budget_allocation( samples=naive_posterior_response, figsize=default_figsize,)```Yes, we do. Let's compare the optimized response against the baseline plan.```{python}#| warning: false# Create scatterplot with spend and mean responsemean_response_v2 = naive_posterior_response.total_media_contribution_original_scale.mean(dim='sample').valuesroas_v2 = mean_response_v2 / spend# Calculate the delta in responseresponse_delta = mean_response_v2.sum() - mean_response.sum()plt.scatter(spend, mean_response_v2, alpha=0.7, s=100, color="blue", label=f"Optimized allocation (+{response_delta:.1f} response, ROAS: {roas_v2:.2f})")plt.scatter(spend, mean_response, alpha=0.7, s=100, color="red", label="Guessed allocation")plt.xlabel('Spend')plt.ylabel('Mean Response')plt.title('Spend vs Mean Response')plt.grid(True, alpha=0.3)plt.legend(fontsize='small', loc='upper left')plt.show()```The optimized allocation is ~$500$ units higher than the guessed allocation, and the new estimated ROAS is $13$ which it's over our expectations. As consequence, we assume we'll get an estimate Y revenue in the next N periods and planning against this incoming cashflow we'll get back.The plotwist? We got a lower response, which mean a lower ROAS and we got in serious financial problems because we don't have enough cash to payback providers or services.Why this happen? Maximizing the mean response is risk-neutral. It often reallocates budget toward regions with potential high returns even if they are weakly identified, increasing dispersion of outcomes. This is rational when stakeholders are indifferent to risk. However, that's not the case for every company. Sometimes our stakeholders need to know how certain we are about expected outcomes.By inspecting posterior predictive samples under each allocation, we can quantify uncertainty and answer this question, based on the model current understanding.Let's plot the response distributions for both baseline and optimized allocations.```{python}#| warning: falsefig, ax = plt.subplots()# Get the valuesoptimized_values = naive_posterior_response.total_media_contribution_original_scale.valuesguessed_values = initial_posterior_response.total_media_contribution_original_scale.values# Plot distributionsaz.plot_dist( optimized_values, color="blue", label="Optimized allocation", ax=ax,)az.plot_dist( guessed_values, color="red", label="Guessed allocation", ax=ax,)# Calculate meansoptimized_mean = optimized_values.mean()guessed_mean = guessed_values.mean()# Add vertical lines for meansax.axvline(optimized_mean, color="blue", linestyle="--", alpha=0.8)ax.axvline(guessed_mean, color="red", linestyle="--", alpha=0.8)# Add text boxes with mean valuesax.text(optimized_mean +10, ax.get_ylim()[1] *0.8, f'Optimized Mean:\n{optimized_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightblue", alpha=0.7), ha='left', va='center')ax.text(guessed_mean -10, ax.get_ylim()[1] *0.6, f'Guessed Mean:\n{guessed_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightcoral", alpha=0.7), ha='right', va='center')plt.title("Response Distribution")plt.xlabel("Total Media Contribution")plt.legend()plt.show()```As expected, the means differ (we optimized to increase it), and so does the certainty around the mean. Like an excersise, lets observe how probable is to get a response higher and lower than the mean.```{python}#| warning: falseaz.plot_posterior( optimized_values, figsize=default_figsize, ref_val=optimized_mean,)plt.show()```This makes everything clear now, the chances of getting some higher or equal than the mean where 43% but the chances of getting some lower than the mean where 56%. It's no surprise that we got a lower response and a lower ROAS.::: {.callout-tip icon=false}## 💡 First TakeawayComparing full distributions makes risk transparent: width quantifies forecast reliability, skewness reveals asymmetry of upside vs downside, and overlaps show practical indistinguishability. :::Where this risk is coming from? The new allocation is riskier, but why? Let's look at each spend level relative to its saturation curve.```{python}#| warning: falsecurve = mmm.saturation.sample_curve( mmm.idata.posterior[["saturation_alpha", "saturation_lam"]], max_value=10)fig, axes = mmm.plot.saturation_curves( curve, original_scale=True, n_samples=10, hdi_probs=0.85, random_seed=rng, subplot_kwargs={"figsize": default_figsize, "ncols": 4, "sharey": True}, rc_params={"xtick.labelsize": 10,"ytick.labelsize": 10,"axes.labelsize": 10,"axes.titlesize": 10, },)# Add vertical lines for optimal allocation on each subplotallocation_values = naive_posterior_response.allocation.valueschannel_names = naive_posterior_response.allocation.channel.valuesfor i, (ax, allocation_value) inenumerate(zip(axes.ravel(), allocation_values)): ax.axvline(allocation_value, color="red", linestyle="--", alpha=0.8, linewidth=2, label="Optimal allocation") ax.title.set_fontsize(10)if fig._suptitle isnotNone: fig._suptitle.set_fontsize(12)plt.tight_layout()plt.show()```Vertical lines are located at the spend allocation given for each channel. For channels as x4, the model has few observations at those spend levels, so posterior bands are wide and the induced response distribution is diffuse. Risk-aware optimization tends to pull spend toward well-identified regions (often near inflection), trading a small mean decrease for a large reduction in variance.Could we understand this in advance? and if so, would we prefer a different type of allocation? Which get us closer to our objective in a safer way? -A narrower distribution with a slightly lower mean can be preferable when shortfall risk is costly-.The short answer is **definetly**. Let's create now a new optimization process that will be risk-aware. # ⚖️ Risk metrics consistent with PyMC-MarketingHere we’ll use a heuristic approximation, *mean tightness score* implemented in the PyMC-Marketing library. **This score combines the mean with a penalty for tail spread**.## 🎯 Mean Tightness Score```{python}ut.mean_tightness_score?```Alpha here ecodes your risk profile (0-1 range), allocations with higher means even if they have big dispersion score better when your alpha is high. When your alpha is low, allocations with lower means but small dispersion score better. We are using a lower alpha in the example, as expected, recommendations for every channel lie in well-known regions.```{python}#| warning: falsemts_budget_allocation, mts_optimizer_result, callback_results = ( optimizable_model.optimize_budget( budget=time_unit_budget, utility_function=ut.mean_tightness_score(alpha=0.15), callback=True, minimize_kwargs={"options": {"maxiter": 2_000, "ftol": 1e-16}}, ))mts_posterior_response = optimizable_model.sample_response_distribution( allocation_strategy=mts_budget_allocation, include_carryover=True, include_last_observations=False, additional_var_names=["y_original_scale"])# Print budget allocation by channelprint("Budget allocation by channel:")for channel in channels:print(f" {channel}: {mts_posterior_response.allocation.sel(channel=channel).astype(int).sum():,}" )print(f"Total Allocated Budget: {np.sum(mts_posterior_response.allocation.to_numpy()):,.0f}")```Great, it looks like the allocation shifts toward better-identified regions. Let's plot the saturation curves to see where the allocation lands.```{python}#| warning: falsecurve = mmm.saturation.sample_curve( mmm.idata.posterior[["saturation_alpha", "saturation_lam"]], max_value=4)fig, axes = mmm.plot.saturation_curves( curve, original_scale=True, n_samples=10, hdi_probs=0.85, random_seed=rng, subplot_kwargs={"figsize": default_figsize, "ncols": 4, "sharey": True}, rc_params={"xtick.labelsize": 10,"ytick.labelsize": 10,"axes.labelsize": 10,"axes.titlesize": 10, },)# Add vertical lines for optimal allocation on each subplotallocation_values = mts_posterior_response.allocation.valuesfor i, (ax, allocation_value) inenumerate(zip(axes.ravel(), allocation_values)): ax.axvline(allocation_value, color="red", linestyle="--", alpha=0.8, linewidth=2, label="Optimal allocation") ax.title.set_fontsize(10)if fig._suptitle isnotNone: fig._suptitle.set_fontsize(12)plt.tight_layout()plt.show()```As expected, recommendations for every channel lie in well-known regions.The consequence: the posterior distribution narrows because budget concentrates in well-learned, less-nonlinear regions.Let's plot posterior distributions for this lower-risk allocation.```{python}#| warning: falsefig, ax = plt.subplots()# Get the valuesoptimized_risk_values = mts_posterior_response.total_media_contribution_original_scale.values# Plot distributionsaz.plot_dist( optimized_values, color="blue", label="Optimized allocation", ax=ax,)az.plot_dist( guessed_values, color="red", label="Guessed allocation", ax=ax,)az.plot_dist( optimized_risk_values, color="green", label="Risk-adjusted allocation", ax=ax,)# Calculate meansrisk_adjusted_mean = optimized_risk_values.mean()# Add vertical lines for meansax.axvline(optimized_mean, color="blue", linestyle="--", alpha=0.8)ax.axvline(guessed_mean, color="red", linestyle="--", alpha=0.8)ax.axvline(risk_adjusted_mean, color="green", linestyle="--", alpha=0.8)# Add text boxes with mean valuesax.text(optimized_mean +10, ax.get_ylim()[1] *0.8, f'Optimized Mean:\n{optimized_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightblue", alpha=0.7), ha='left', va='center')ax.text(guessed_mean -10, ax.get_ylim()[1] *0.6, f'Guessed Mean:\n{guessed_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightcoral", alpha=0.7), ha='right', va='center')ax.text(risk_adjusted_mean -10, ax.get_ylim()[1] *0.4, f'Risk-adjusted Mean:\n{risk_adjusted_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightgreen", alpha=0.7), ha='right', va='center')plt.title("Response Distribution")plt.xlabel("Total Media Contribution")plt.legend()plt.show()```This makes it clear: we gained much more certainty—a risk-averse (lower-variance) response distribution. You may be thinking that playing in known regions tends to reduce the mean. Do you want to know why?Posterior response curves tend to be more certain at the origin because two sources of uncertainty are minimized there: structurally, we know that zero spend produces zero incremental effect, and empirically, the lowest spend region is often well supported in historical data. As spend increases, especially beyond historically observed levels, epistemic uncertainty about the saturation and curvature parameters dominates, widening the credible intervals.Does that mean we are doomed to lower values if we want certainty? Not at all, we can change the utility to prefer riskier options 🔥.Let's run a more risk-seeking allocation 👀```{python}#| warning: falseinverse_mts_budget_allocation, inverse_mts_optimizer_result, callback_results = ( optimizable_model.optimize_budget( budget=time_unit_budget, utility_function=ut.mean_tightness_score(alpha=0.95), callback=True, minimize_kwargs={"options": {"maxiter": 2_000, "ftol": 1e-16}}, ))inverse_mts_posterior_response = optimizable_model.sample_response_distribution( allocation_strategy=inverse_mts_budget_allocation, include_carryover=True, include_last_observations=False, additional_var_names=["y_original_scale"])# Print budget allocation by channelprint("Budget allocation by channel:")for channel in channels:print(f" {channel}: {inverse_mts_posterior_response.allocation.sel(channel=channel).astype(int).sum():,}" )print(f"Total Allocated Budget: {np.sum(inverse_mts_posterior_response.allocation.to_numpy()):,.0f}")```Flipping the tightness preference (alpha parameter) induces risk-seeking behavior, moving allocations toward higher-variance, high-upside regions.Now we choose an allocation that is less certain but with higher potential upside than the baseline. Let's plot the response distributions. ::: {.callout-tip icon=false}## 💡 Second TakeawayDiscover your risk preferences and adjust your objective function to reflect them. You don't need to commit to a single function or approach, you can build a custom one which tailor your needs.:::```{python}#| warning: falsefig, ax = plt.subplots()# Get the valuesoptimized_inverse_risk_values = inverse_mts_posterior_response.total_media_contribution_original_scale.values# Plot distributionsaz.plot_dist( optimized_values, color="blue", label="Optimized allocation", ax=ax,)az.plot_dist( guessed_values, color="red", label="Guessed allocation", ax=ax,)az.plot_dist( optimized_risk_values, color="green", label="Risk-adjusted allocation", ax=ax,)az.plot_dist( optimized_inverse_risk_values, color="orange", label="Inverse Risk-adjusted allocation", ax=ax,)# Calculate meansinverse_risk_adjusted_mean = optimized_inverse_risk_values.mean()# Add vertical lines for meansax.axvline(optimized_mean, color="blue", linestyle="--", alpha=0.8)ax.axvline(guessed_mean, color="red", linestyle="--", alpha=0.8)ax.axvline(risk_adjusted_mean, color="green", linestyle="--", alpha=0.8)ax.axvline(inverse_risk_adjusted_mean, color="orange", linestyle="--", alpha=0.8)# Add text boxes with mean valuesax.text(optimized_mean +10, ax.get_ylim()[1] *0.8, f'Optimized Mean:\n{optimized_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightblue", alpha=0.7), ha='left', va='center')ax.text(guessed_mean -10, ax.get_ylim()[1] *0.6, f'Guessed Mean:\n{guessed_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightcoral", alpha=0.7), ha='right', va='center')ax.text(risk_adjusted_mean -10, ax.get_ylim()[1] *0.4, f'Risk-adjusted Mean:\n{risk_adjusted_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="lightgreen", alpha=0.7), ha='right', va='center')ax.text(inverse_risk_adjusted_mean -10, ax.get_ylim()[1] *0.2, f'Inverse Risk-adjusted Mean:\n{inverse_risk_adjusted_mean:.1f}', bbox=dict(boxstyle="round,pad=0.3", facecolor="orange", alpha=0.7), ha='right', va='center')plt.title("Response Distribution")plt.xlabel("Total Media Contribution")plt.legend()plt.show()```Great, the new allocation is riskier, and the mean is higher (still less uncertant than the risk-neutral allocation). We can go beyond visuals and quantify this.Because all are posterior distributions, we can check the density that has each response distribution at their respective mean. We'll be using kernel density estimation (KDE). This value, denoted $\hat{f}(\mu)$, represents the estimated height of the probability density function at the mean. Importantly, this is not itself a probability but a density, with units of “1 over the units of the variable.” Higher values of $\hat{f}(\mu)$ indicate that the distribution is sharply peaked around the mean, reflecting greater certainty that posterior draws will lie close to the central value. Conversely, lower values correspond to flatter, more diffuse posteriors, indicating higher uncertainty.Let's check the density at the mean for each allocation.```{python}#| warning: falsefrom scipy.stats import gaussian_kdedef kde_density_at_point(x, x0):"""Gaussian KDE density estimate at x0 using Scott's rule bandwidth.""" kde = gaussian_kde(x) # Scott's rule by defaultreturnfloat(kde.evaluate([x0])[0])optimized_density = kde_density_at_point(optimized_values, optimized_mean)guessed_density = kde_density_at_point(guessed_values, guessed_mean)risk_adjusted_density = kde_density_at_point(optimized_risk_values, risk_adjusted_mean)inverse_risk_adjusted_density = kde_density_at_point(optimized_inverse_risk_values, inverse_risk_adjusted_mean)print(f"Optimized allocation response density at mean: {optimized_density:.3f}")print(f"Guessed allocation response density at mean: {guessed_density:.3f}")print(f"Risk-adjusted allocation response density at mean: {risk_adjusted_density:.3f}")print(f"Inverse Risk-adjusted allocation response density at mean: {inverse_risk_adjusted_density:.3f}")```The density estimations tell the same story as the plots. How can we use this to take actions? For example, suppose we want to hit a target ROAS of $9.5$, then we can check the density of the ROAS distribution at $9.5$ for each response distribution given their respective allocation strategy.```{python}#| warning: falseoptimized_roas = optimized_values / (time_unit_budget*num_periods)guessed_roas = guessed_values / (time_unit_budget*num_periods)risk_adjusted_roas = optimized_risk_values / (time_unit_budget*num_periods)inverse_risk_adjusted_roas = optimized_inverse_risk_values / (time_unit_budget*num_periods)# Calculate kde density at 9.5_target_roas =9.5optimized_kde_density = kde_density_at_point(optimized_roas, _target_roas)guessed_kde_density = kde_density_at_point(guessed_roas, _target_roas)risk_adjusted_kde_density = kde_density_at_point(risk_adjusted_roas, _target_roas)inverse_risk_adjusted_kde_density = kde_density_at_point(inverse_risk_adjusted_roas, _target_roas)#plot the ROAS distributionsfig, ax = plt.subplots()# Plot distributionsaz.plot_dist(optimized_roas, color="blue", label=f"Optimized allocation: {optimized_kde_density:.3f}", ax=ax)az.plot_dist(guessed_roas, color="red", label=f"Guessed allocation: {guessed_kde_density:.3f}", ax=ax)az.plot_dist(risk_adjusted_roas, color="green", label=f"Risk-adjusted allocation: {risk_adjusted_kde_density:.3f}", ax=ax)az.plot_dist(inverse_risk_adjusted_roas, color="orange", label=f"Inverse Risk-adjusted allocation: {inverse_risk_adjusted_kde_density:.3f}", ax=ax)# Add vertical lines for meansax.axvline(_target_roas, color="black", linestyle="--", alpha=0.8, label="Target ROAS")plt.tight_layout()plt.title("ROAS Distribution")plt.xlabel("ROAS")plt.legend()plt.show()```If we want to hit a target ROAS of $9.5$, the risk-neutral optimized allocation is the most certain, followed by the inverse risk-adjusted allocation.If instead our target ROAS is $7$, the inverse risk-adjusted allocation concentrates more density around that value, and the risk-neutral optimized allocation has less density around it.```{python}#| warning: false# Calculate kde density at 7_roas_target =7optimized_kde_density = kde_density_at_point(optimized_roas, _roas_target)guessed_kde_density = kde_density_at_point(guessed_roas, _roas_target)risk_adjusted_kde_density = kde_density_at_point(risk_adjusted_roas, _roas_target)inverse_risk_adjusted_kde_density = kde_density_at_point(inverse_risk_adjusted_roas, _roas_target)#plot the ROAS distributionsfig, ax = plt.subplots()# Plot distributionsaz.plot_dist(optimized_roas, color="blue", label=f"Optimized allocation: {optimized_kde_density:.3f}", ax=ax)az.plot_dist(guessed_roas, color="red", label=f"Guessed allocation: {guessed_kde_density:.3f}", ax=ax)az.plot_dist(risk_adjusted_roas, color="green", label=f"Risk-adjusted allocation: {risk_adjusted_kde_density:.3f}", ax=ax)az.plot_dist(inverse_risk_adjusted_roas, color="orange", label=f"Inverse Risk-adjusted allocation: {inverse_risk_adjusted_kde_density:.3f}", ax=ax)# Add vertical lines for meansax.axvline(_roas_target, color="black", linestyle="--", alpha=0.8, label="Target ROAS")plt.tight_layout()plt.title("ROAS Distribution")plt.xlabel("ROAS")plt.legend()plt.show()```Under this paradigm, you can define a target estimate and select an allocation that maximizes the probability of hitting it. One way is to create a function that reduces variance with respect to the target, favoring narrower distributions with density near the target.Let's make this custom utility function, and see how it performs.```{python}#| warning: falseimport pytensor.tensor as ptimport pymc_marketing.mmm.utility as utdef target_hit_probability(target, num_periods):""" Target hit probability utility function. Minimizing the mean squared error between predicted ROAS and the target Adding a variance penalty to encourage tighter distributions. Parameters ---------- target : float The target ROAS value to optimize towards num_periods : int Number of time periods for the budget allocation Returns ------- callable A utility function that can be used with the budget optimizer. Returns negative objective (since optimizer minimizes). """def _function(samples, budgets): roas_samples = samples / (pt.sum(budgets) * num_periods)# Use mean squared error from target, which provides smoother gradients mse_from_target = pt.mean((roas_samples - target) **2)# Add penalty for variance to encourage tighter distributions around target variance_penalty = pt.var(roas_samples)# Combine MSE and variance penalty with weighting# Higher variance penalty encourages narrower distributions total_objective = mse_from_target +0.1* variance_penaltyreturn-total_objectivereturn _function_roas_target =10custom_utility_budget_allocation, custom_utility_optimizer_result, callback_results = ( optimizable_model.optimize_budget( budget=time_unit_budget, utility_function=target_hit_probability(_roas_target, num_periods), callback=True, minimize_kwargs={"options": {"maxiter": 2_000}}, ))custom_utility_posterior_response = optimizable_model.sample_response_distribution( allocation_strategy=custom_utility_budget_allocation, include_carryover=True, include_last_observations=False, additional_var_names=["y_original_scale"])# Print budget allocation by channelprint("Budget allocation by channel:")for channel in channels:print(f" {channel}: {custom_utility_posterior_response.allocation.sel(channel=channel).astype(int).sum():,}" )print(f"Total Allocated Budget: {np.sum(custom_utility_posterior_response.allocation.to_numpy()):,.0f}")```The allocation is similar to those observed before. Let's plot the ROAS distributions.```{python}#| warning: falsecustom_utility_values = custom_utility_posterior_response.total_media_contribution_original_scale.valuescustom_utility_roas = custom_utility_values / (time_unit_budget*num_periods)optimized_kde_density = kde_density_at_point(optimized_roas, _roas_target)guessed_kde_density = kde_density_at_point(guessed_roas, _roas_target)risk_adjusted_kde_density = kde_density_at_point(risk_adjusted_roas, _roas_target)inverse_risk_adjusted_kde_density = kde_density_at_point(inverse_risk_adjusted_roas, _roas_target)custom_utility_kde_density = kde_density_at_point(custom_utility_roas, _roas_target)#plot the ROAS distributionsfig, ax = plt.subplots()# Plot distributionsaz.plot_dist(optimized_roas, color="blue", label=f"Optimized allocation: {optimized_kde_density:.3f}", ax=ax)az.plot_dist(guessed_roas, color="red", label=f"Guessed allocation: {guessed_kde_density:.3f}", ax=ax)az.plot_dist(risk_adjusted_roas, color="green", label=f"Risk-adjusted allocation: {risk_adjusted_kde_density:.3f}", ax=ax)az.plot_dist(inverse_risk_adjusted_roas, color="orange", label=f"Inverse Risk-adjusted allocation: {inverse_risk_adjusted_kde_density:.3f}", ax=ax)az.plot_dist(custom_utility_roas, color="purple", label=f"Custom utility allocation: {custom_utility_kde_density:.3f}", ax=ax)# Add vertical lines for meansax.axvline(_roas_target, color="black", linestyle="--", alpha=0.8, label="Target ROAS")plt.tight_layout()plt.title("ROAS Distribution")plt.xlabel("ROAS")plt.legend()plt.show()```Great 🙌🏻 The initial optimized allocation which was risk neutral, had initially the higher density around the target ROAS, but the density around it was not high enough, the new allocation bring a more certain answer around the target, because the objective function was built for it.::: {.callout-tip icon=false}## 💡 Key InsightHere we have a custom utility function that allows us to optimize for a target ROAS. Nevertheless, you can build other utilities and use them as objectives. You can also introduce risk-aware constraints—without on top of your business constraints.:::Let's observe our final posterior around the target ROAS.```{python}#| warning: falseaz.plot_posterior( custom_utility_roas, ref_val=_roas_target)plt.show()```We could say: the probability of achieving ROAS ≥ 10 with this allocation is 31%, and ROAS < 10 is 69%. If we need more certainty, we can make the optimization more risk-averse.Now, if you want to think really bayesian, then you can define a region of practical equivalence, and check the probability of the ROAS being in that region. For example, you can ask yourself: Would I do something different if ROAS is 7, 9 or 11? If the answer it's no, then you find your ROPE. Let's say we want to know the probability of the ROAS being between $7$ and $11$.```{python}#| warning: false# Calculate probability of ROAS being between 7 and 9prob_7_to_11 = np.mean((custom_utility_roas >=7) & (custom_utility_roas <=11))# Plot posterior with reference values and regionfig, ax = plt.subplots()az.plot_posterior( custom_utility_roas, ref_val=_roas_target, ax=ax)# Add vertical lines for the region of interestax.axvline(7, color="black", linestyle="--", alpha=0.7, label="ROAS = 7")ax.axvline(11, color="black", linestyle="--", alpha=0.7, label="ROAS = 11")# Add text box with probabilityax.text(0.02, 0.98, f'P(7 ≤ ROAS ≤ 11) = {prob_7_to_11:.2%}', transform=ax.transAxes, bbox=dict(boxstyle="round,pad=0.3", facecolor="lightblue", alpha=0.8), ha='left', va='top', fontsize=12)plt.show()```::: {.callout-tip icon=false}## 💡 Key InsightYou can **define a region of practical equivalence (ROPE)**, in order to be more precise with your decision making. This is quite natural way to think about a problem, and lightens the burden of the decision maker to commit to a single number. At the end of the day, we don't need to be 99.999% precise around every single answer, or number, we can be 95% or 90% precise and sometimes that's enough. *Identify if thats your case, and think accordingly*.:::# ✅ Takeaways on uncertainty- **Treat uncertainty as first-class**: Optimize over the full posterior predictive, not point estimates. Compare plans by their distributions, not just expected means.- **Understand uncertainty types**: Aleatoric (irreducible noise) vs epistemic (learnable model/parameter uncertainty). Planning choices mostly shift epistemic risk; always communicate both.- **Find your risk appetite**: Ask stakeholders how certain we must be about reported results. What changes if they are a bit higher or lower?- **Choose a utility aligned to risk appetite**: Working with the mean is risk-neutral; quantiles, TailDistance, CVaR, or MTS are more risk-aware.- **Communicate distributions, not single numbers**: Show HDIs/quantiles and probabilities (e.g., P(ROAS ≥ target)). It's better to understand the full spectrum of possibilities than to follow single numbers and be short-sighted.- **Define a region of practical equivalence (ROPE)**: Once you are comfortable with the uncertainty, play with ROPEs and find out how much you could lighten the estimated answer, and if you will do anything different if this one change under a range of values.# 🚧 Limitations- This approach represents the model’s confidence, but models can be very certain about a wrong answer. Always add business knowledge and guardrails to keep recommendations realistic.# ConclusionHope this article was helpful to understand how to use Bayesian media mix models to optimize your media spend. Understand uncertanty it's a powerful tool to make better decisions, but it's not a silver bullet.The current example is a simple one, real life applications are more complex and require more sophisticated models, risk functions, and complex optimization problems, where constraints and business knowledge are key.At [PyMC Labs](https://www.pymc-labs.com/) we're building tools to make this process easier. If you're interested in learning more, explore the PyMC‑Marketing [Example Gallery](https://www.pymc-marketing.io/en/stable/gallery/gallery.html) and [API](https://www.pymc-marketing.io/en/stable/api/index.html), our [documentation](https://docs.pymc-marketing.com/) and [blog](https://www.pymc-labs.com/blog-posts).You can get a 30 minutes free consultation with our team to discuss your specific needs and how we can help you.- 1:1 Session with me: [Book a call](https://calendar.app.google/vX9DziLkdMSAAszU8)- Discovery session with PyMC Labs team: [Book a call](https://www.pymc-labs.com/?utm_source=carlos_trujillo&utm_medium=pydata_berlin&utm_campaign=bayesian_mmm_article)Thanks if you read this far!